SFRF6D: Selective Fewer-Reference Fusion for 6D Pose Estimation
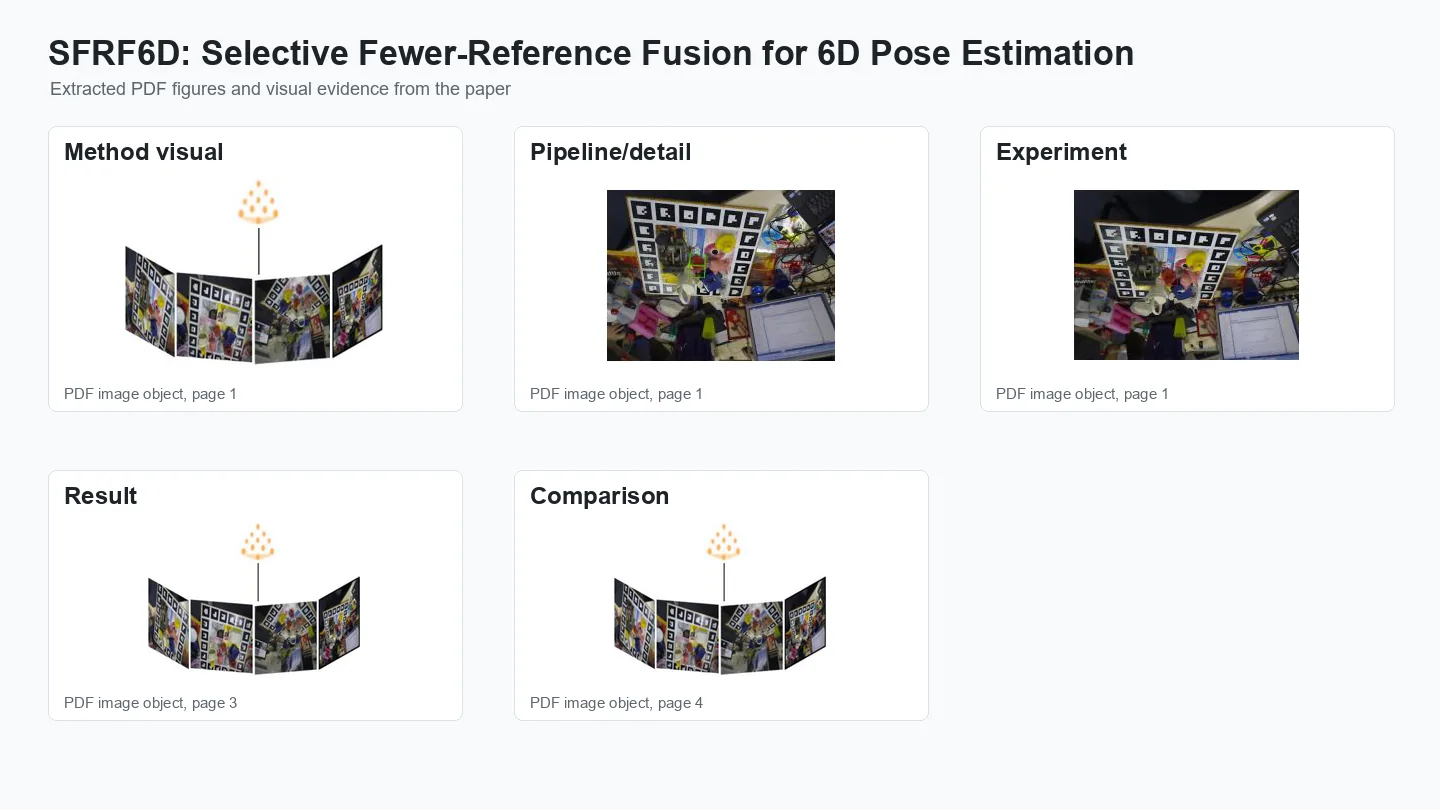
一句话看懂SFRF6D 不需要 CAD 模型,仅凭四张 RGB-D 参考图像即可估计物体的 6D 位姿:先重建粗略的三维形状,再让匹配集中于可见区域,在 LM、LMO 和 YCB-Video 上平均 ADD(-S) 精度(位姿误差小于物体直径的 0.1 倍)达到 83.2%。
问题背景
6D 位姿估计是指求出物体的三维旋转和三维平移,这正是机器人进行精密抓取和装配所需的信息。现有方法大多依赖物体的 CAD 模型,或者依赖大量参考图像。基于模型的方法将图像特征与 CAD 模型进行匹配,而在实际场景中往往没有现成的模型,应用因此受限。Gen6D、OnePose、FoundationPose 等无需物体模型的方法改为从大量参考图像或视频中构建多视角表示,但在严重遮挡或视角变化较大时,跨视角对齐难以保持稳定。只需少量参考图像的方法,在参考视角之间几乎没有重叠时,特征匹配能力会大幅下降。
SFRF6D 的目标是:不使用 CAD 模型,只借助少量已知位姿的 RGB-D 参考图像完成位姿估计,同时在物体被严重遮挡时依然保持鲁棒。
方法原理
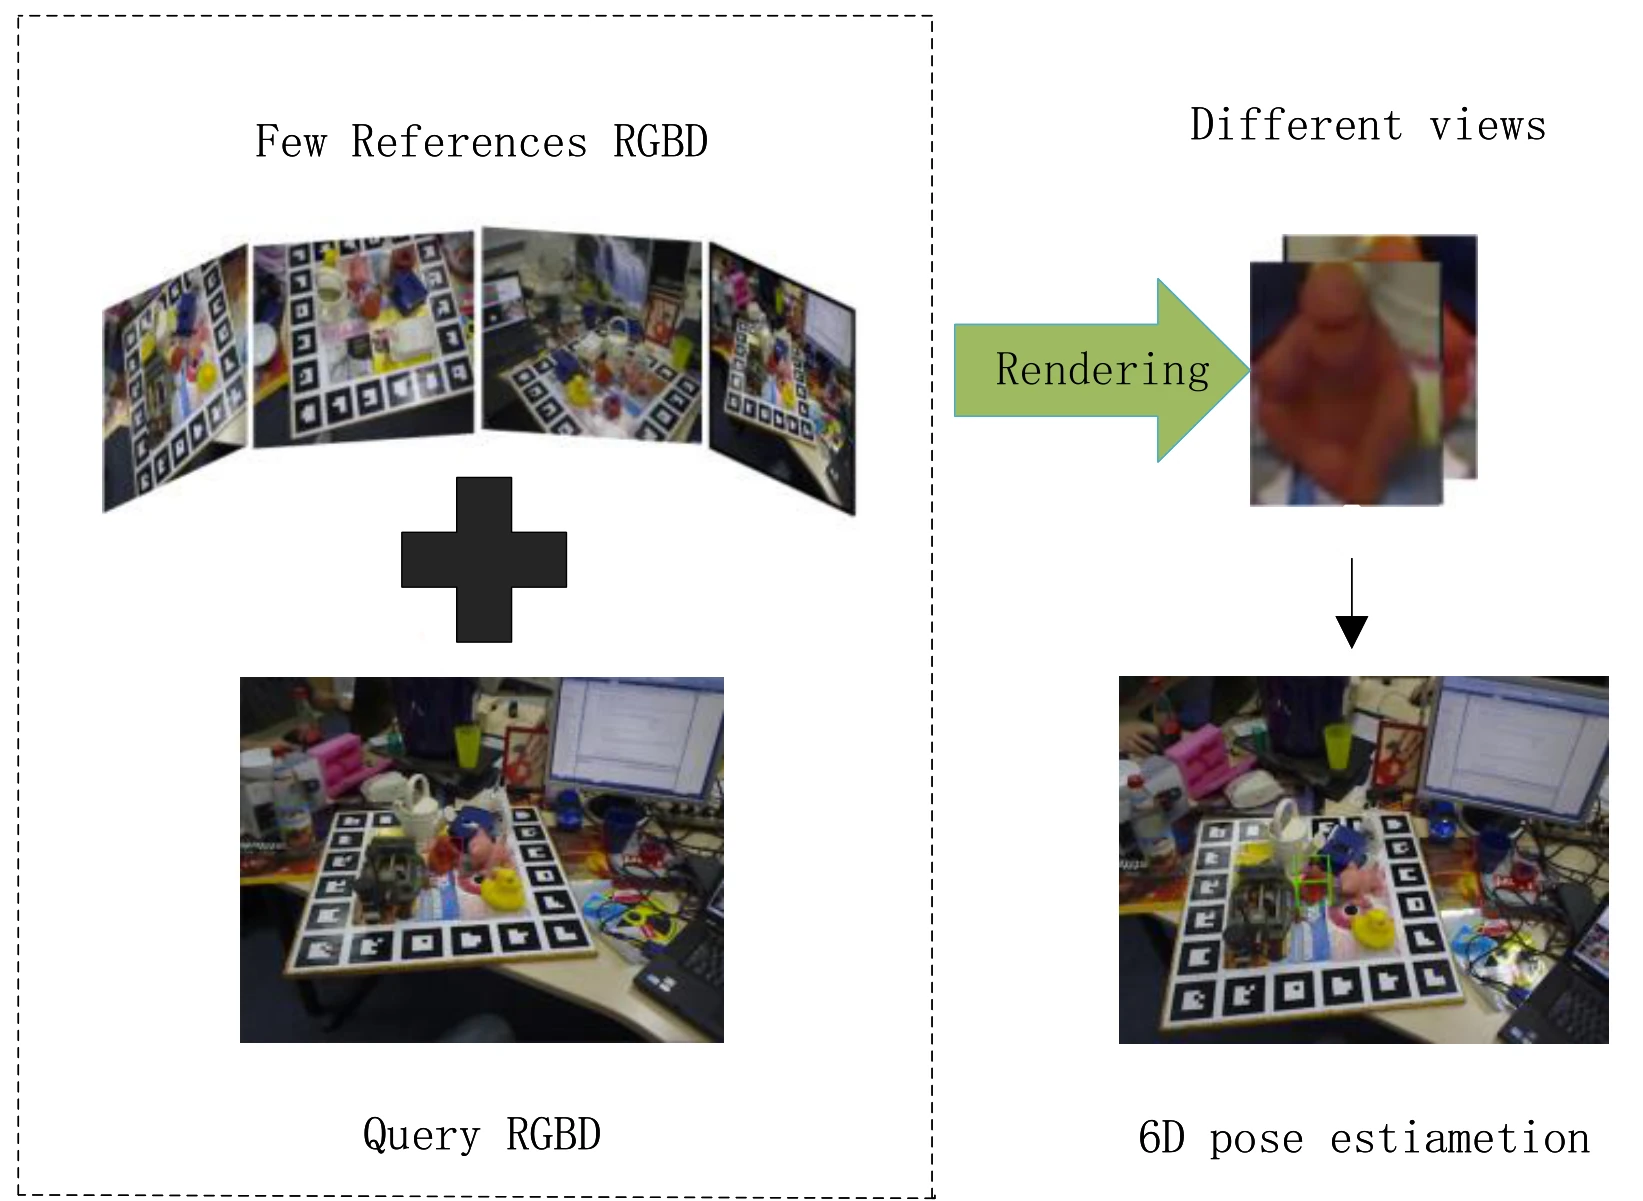
SFRF6D 先由参考图像重建物体的粗略三维形状,并与查询图像进行粗对齐;然后在该粗略位姿下渲染参考视角,借助由三维几何引导的注意力与查询图像匹配,使可见区域发挥作用、被遮挡区域不参与匹配;最后对位姿进行精化,并通过渲染比较在多个位姿假设中做出选择。
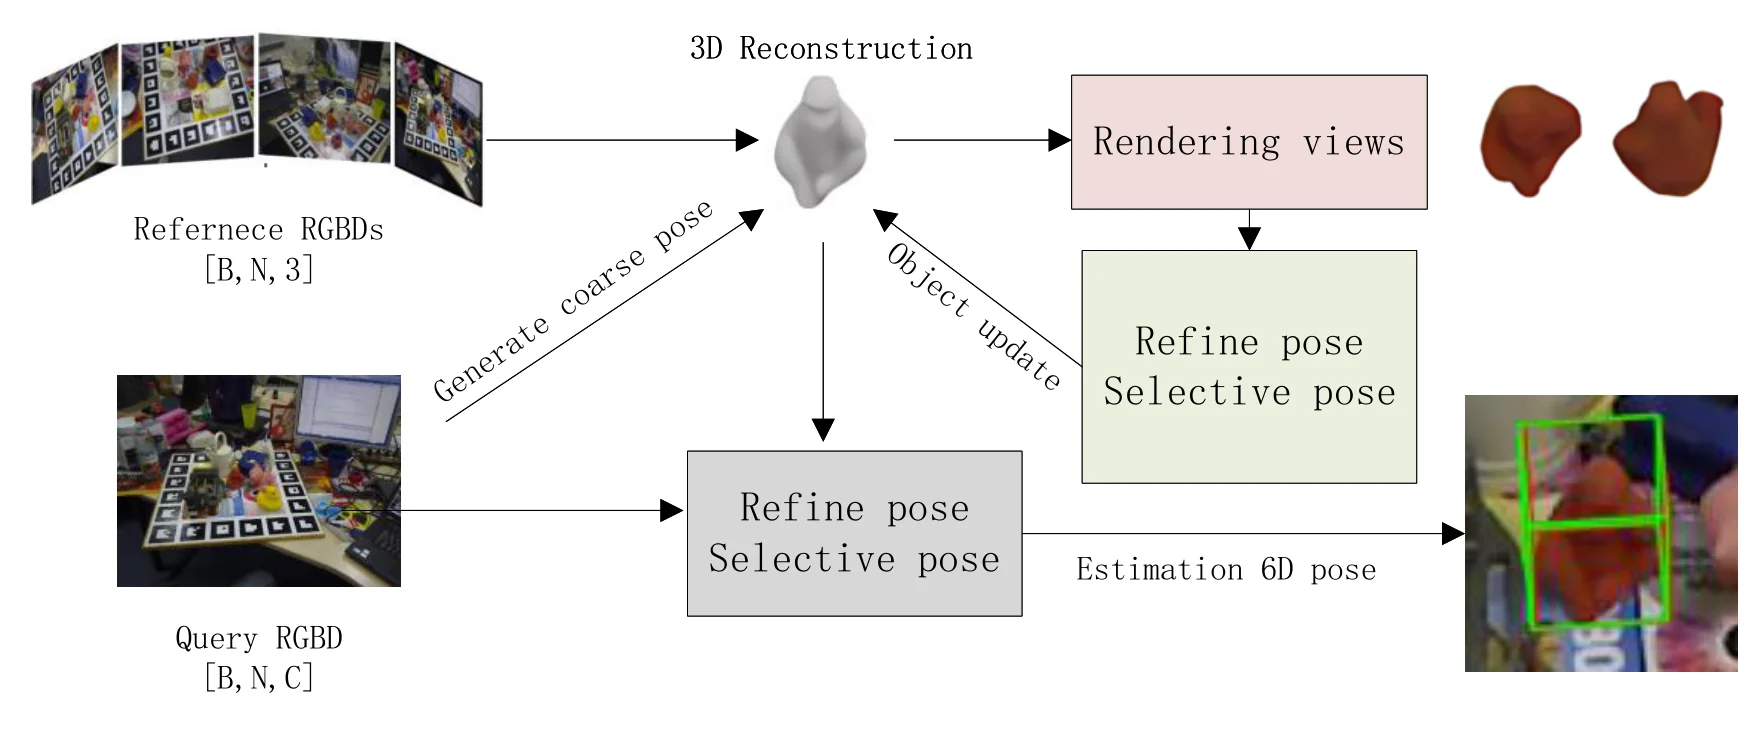
少量参考图像与一张查询图像。 输入是一小组带真值位姿的 RGB-D 参考图像(主实验中为四张)和一张 RGB-D 查询图像,查询掩码将物体分割出来。
粗略三维形状。 选取视角与查询图像最接近的参考图像作为锚点,用 ResNet18 提取其特征,并由其深度图生成初始的物体点云。其余参考图像借助相机内参和已知位姿变换到同一世界坐标系中,补全物体形状,再将其归一化到 [−1, 1] 范围内。
粗对齐。 用有向包围盒求出物体的中心(点云的均值)和旋转(对点云协方差做主成分分析得到的主轴)。由于此时的对齐仍较粗糙,再以最大化重叠(IoU)为目标调整旋转和尺度,得到粗对齐结果。
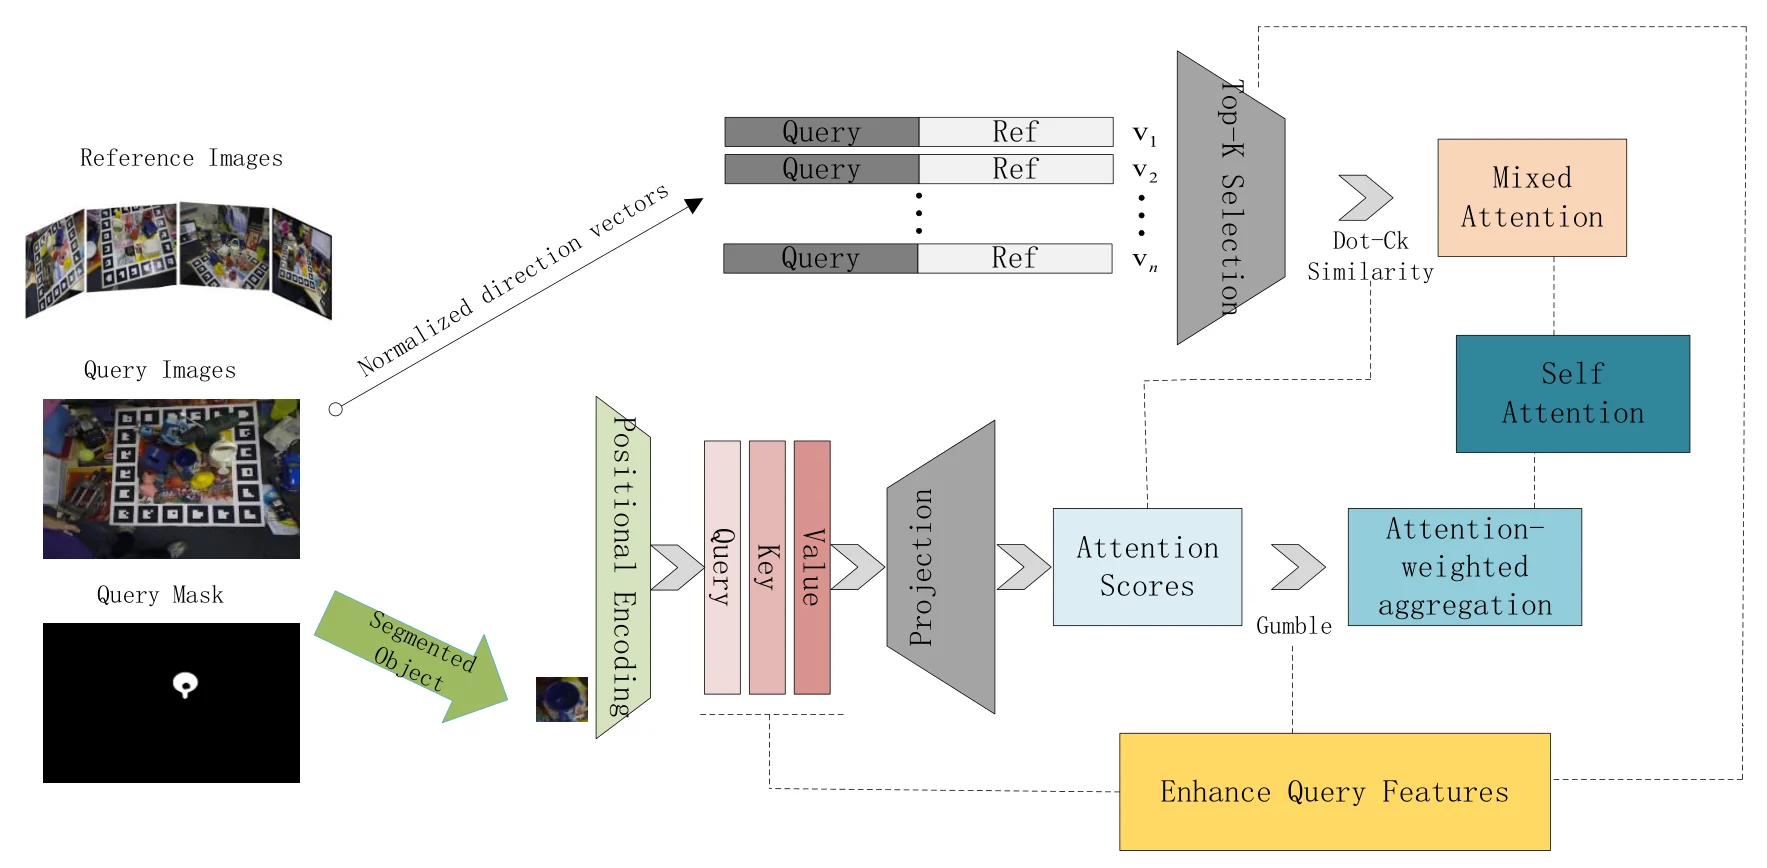
几何引导的稀疏注意力。 在查询图像的粗略位姿下渲染参考点云。参考点与查询点之间的归一化方向向量为交叉注意力构建 Top-K 掩码,并采用 Gumbel-Softmax 进行软性 Top-K 采样;匹配失败的点对被屏蔽,使注意力集中于可见且相关的区域。多尺度融合模块则自适应地权衡全局特征与局部特征。
精化与选择。 精化: 联合优化物体尺度和位姿:位姿通过渲染物体形状、最小化其与锚点图像之间的投影误差来优化;尺度则在给定范围内采样,依据与重建形状之间的 IoU 选取。随后求出相对于查询图像的位姿。
选择: 每个位姿假设被渲染后与查询图像比较,得到一个特征向量;自注意力模块综合所有假设给出评分,再经 Top-K 筛选得到最终位姿。
实验结果
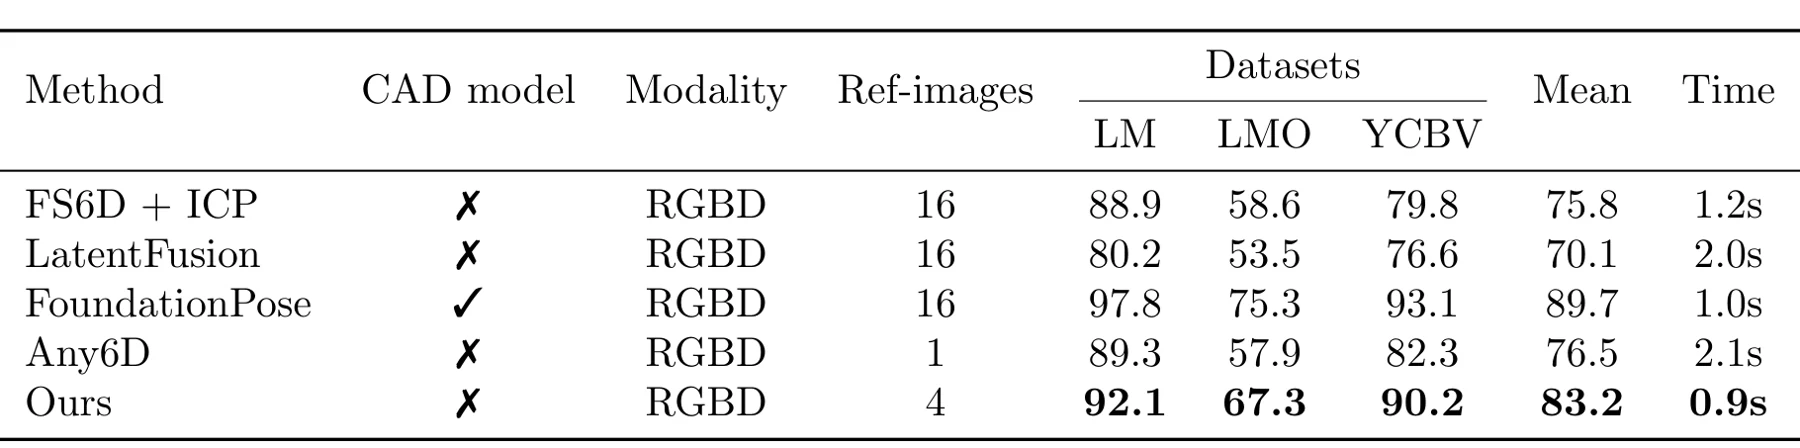
对比实验使用 BOP 的三个基准:LINEMOD(LM)、物体可见比例有时不足 40% 的 Occlusion LINEMOD(LMO),以及 YCB-Video(YCBV)。精度指标为阈值取物体直径 0.1 倍时的 ADD(-S)。在不使用 CAD 模型的方法中,SFRF6D 在三个数据集上的精度均最高(92.1%、67.3% 和 90.2%),速度也最快。使用 CAD 模型的 FoundationPose 精度仍然更高,平均为 89.7%,耗时 1.0 s;作者指出,SFRF6D 的精度略低,但换来了无需 CAD 模型和更小的计算量。
LMO 上的消融实验(表 2)分别考察了各个部分。去掉视角选择器(它在渲染视角中做选择)、改用全部渲染视角时,精度变化不大(66.2%),但耗时从 0.94 s 增加到 1.32 s。参考图像较少时,数量的影响最大:一张为 57.3%,两张为 63.4%,四张为 67.3%,八张为 68.1%(耗时 1.03 s),因此作者选用四张,以兼顾精度与开销。只有一张参考图像时,重建的形状严重依赖这一个视角,遮挡或视角差异较大时特征无法稳健对齐。作者将引入预训练基础模型、动态场景中的多物体交互,以及面向移动端和边缘计算平台的模型轻量化列为未来工作。
引用
@inproceedings{zhang2025sfrf6d,
  title={SFRF6D: Selective Fewer-Reference Fusion for 6D Pose Estimation},
  author={Zhang, Qinghui and Zhou, Chi and Pan, Wei and Lu, Lei},
  booktitle={Proceedings of the Australasian Conference on Robotics and Automation (ACRA 2025)},
  year={2025},
  organization={https://ssl.linklings.net/conferences/acra/acra2025\_proceedings/views~…}
}