GCMA6D: Graph Convolution and Cross-Modality Attention Fusion for 6D Pose Estimation
一句话看懂GCMA6D 从单张 RGB-D 图像估计物体的三维旋转和平移:图卷积刻画局部形状,注意力机制让颜色与几何相互补充,在 LineMOD 上准确率达到 97.7%,比 DenseFusion 高 3.4 个百分点。
问题背景
6D 位姿估计的任务是求出物体相对于相机的三维旋转和平移,是机器人抓取操作和增强现实的关键环节。对于弱纹理物体或部分被遮挡的物体,这一任务仍然困难。仅用 RGB 图像的方法缺少深度信息,在复杂环境中鲁棒性有限。DenseFusion 等 RGB-D 方法在像素级融合颜色与点云特征,但几何特征由 PointNet 提取,可能丢失精细的局部细节。PVN3D 等方法加入了局部特征建模,却增加了计算开销;大规模基础模型的体量和推理延迟也妨碍了实时部署。
GCMA6D 以 DenseFusion 的像素级融合为基础(DenseFusion 也是其消融实验的基线),并对各个环节分别加强:用图卷积刻画局部几何,用大核注意力强化图像特征,再用跨模态注意力模块让颜色与几何在融合之前相互交互。
方法原理
网络输入单张 RGB-D 图像:先分割出目标物体,再分别从图像块中提取颜色特征、从物体点云中提取几何特征,用注意力机制将二者融合,最后由物体上的每个像素回归位姿。
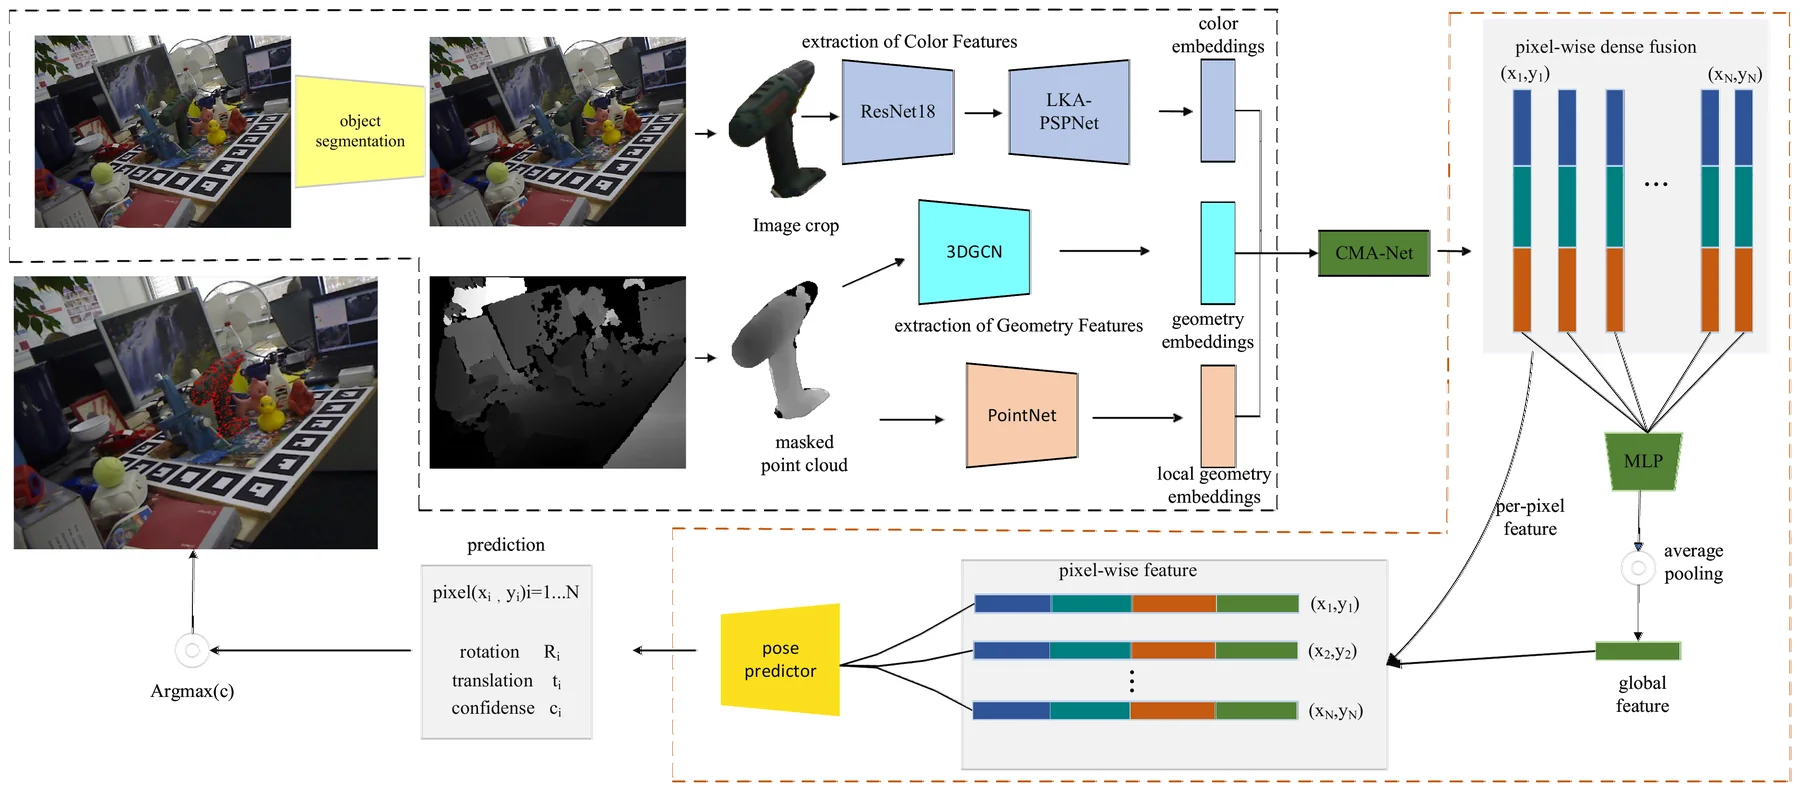
- 分割与裁剪。 采用 PoseCNN 的语义分割网络为每个物体生成掩码。利用掩码裁剪彩色图像,并从深度图中抠出物体区域,再借助相机内参将其转换为三维点云。这一步在计算特征之前就抑制了背景干扰。
- 基于大核注意力的颜色特征。 ResNet18 骨干网络与金字塔池化模块从图像块中提取多尺度特征。大核注意力由深度卷积、深度空洞卷积和 1×1 卷积组成,生成的注意力图与特征逐元素相乘,使网络既能捕捉局部纹理和边缘,也能建模更大范围的上下文。
- 基于 3DGCN 与 PointNet 的几何特征。 三维图卷积网络(3DGCN)在每个点的邻域上施加可学习的三维图卷积核,再经图最大池化,刻画局部几何结构。PointNet 分支用全连接层处理各点,并通过最大池化得到全局形状特征。
- 跨模态注意力。 CMA-Net 模块的输入为颜色特征(F1)、3DGCN 特征(F2)和 PointNet 特征(F3)。第一次点积注意力以 F1、F2、F3 分别作为查询、键和值,增强颜色特征;第二次以 F2、F1、F3 作为查询、键和值,增强点云特征。两路输出与 F3 一起经 Squeeze-and-Excitation 模块进行通道重加权,再拼接在一起。
- 稠密融合与位姿回归。 各像素的融合特征经共享 MLP 和平均池化得到全局特征,并拼接到每个像素的特征上。随后每个像素分别预测旋转、平移和置信度,保留置信度最高的预测;最后沿用 DenseFusion 的做法,由一个小型网络预测残差位姿,对其进行迭代精化。
实验结果
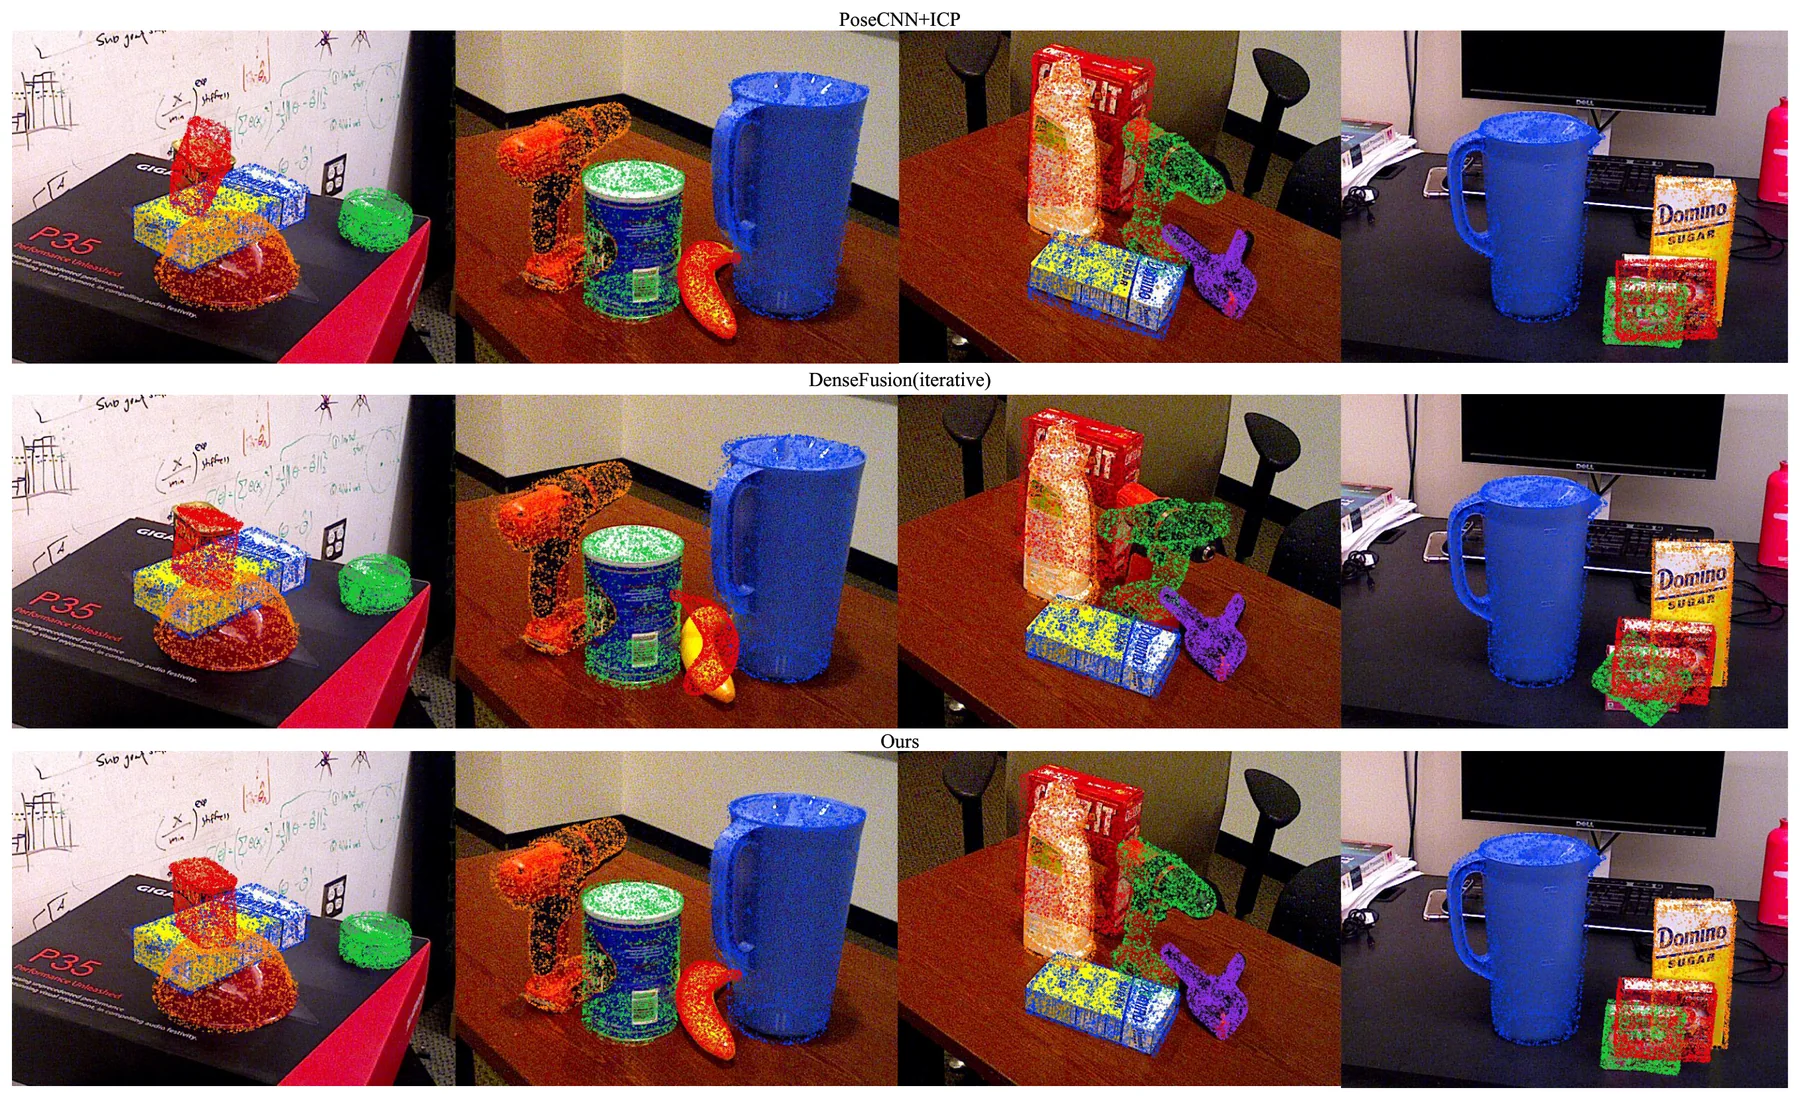
实验在两个公开数据集上进行。LineMOD 中的物体纹理较弱、背景复杂且光照多变;15% 的图像用于训练、85% 用于测试,位姿的 ADD 距离(对称物体用 ADD-S)小于物体直径的 10% 即视为正确。在表 2 中,GCMA6D 的平均准确率在参与比较的七种方法中最高,领先 TMFNet(96.8%)和 QaQ(95.3%),并在对称物体 eggbox 和 glue 上达到 100%。LineMOD 上的消融实验表明各模块相互补充:任意两个模块组合的准确率为 96.8%–97.4%,三者同时使用时达到 97.7%。
YCB-Video 包含 21 种物体,遮挡程度各不相同;测试使用 12 段视频中的 2,949 个关键帧。评价指标为阈值 0–10 cm 范围内 ADD(-S) 准确率曲线下的面积(AUC),以及误差小于 2 cm 的位姿所占比例。GCMA6D 的 AUC 为 92.9%,高于 SaMfNet(92.6%)、G2L-Net(92.4%)、MSCNet(91.5%)和 DenseFusion(91.2%)。作者指出,大号夹子和特大号夹子上的准确率较低:两者外观十分相似,PoseCNN 的语义分割难以为它们生成精确的掩码。作者还指出,高度对称或严重遮挡的物体仍是该方法的局限,后续将改进对背景掩码区域的处理。
引用
@inproceedings{zhang2025gcma6d,
  title={GCMA6D: Graph Convolution and Cross-Modality Attention Fusion for 6D Pose Estimation},
  author={Zhang, Shihan and Cao, Ling and Pan, Wei and Lu, Lei},
  booktitle={Proceedings of the Australasian Conference on Robotics and Automation (ACRA 2025)},
  year={2025},
  organization={https://ssl.linklings.net/conferences/acra/acra2025\_proceedings/views~…}
}