Parallel Curvature Filter for High Performance Image Processing
一句话看懂PCF 将曲率滤波中每个像素的 8 个距离计算改写为 GPU 上的并行卷积,单块显卡每秒可处理 332 亿像素,足以满足视频和生物医学图像的实时处理需求。
问题背景
曲率滤波通过隐式地降低曲率能量(如高斯曲率、平均曲率或全变分)来实现图像平滑和去噪。它把图像视为一张曲面,对每个像素反复施加计算量很小的局部算子,每一轮迭代都使正则化能量下降。曲率滤波本身已经很快,但许多待增强的图像分辨率很高,或者需要实时、准实时处理;在 CPU 上,处理一幅 2048 × 2048 的大图仍需数分钟。
曲率滤波中计算量最大的部分是对图像的 8 次卷积。受 GPU 处理卷积神经网络中卷积运算的启发,作者将这些卷积放到 GPU 上并行计算。
方法原理
曲率滤波的每次迭代为每个像素枚举 8 种候选更新量,从中选出最小的一个并加以应用。PCF 在 GPU 上用卷积核一次性为所有像素计算这 8 个候选量。
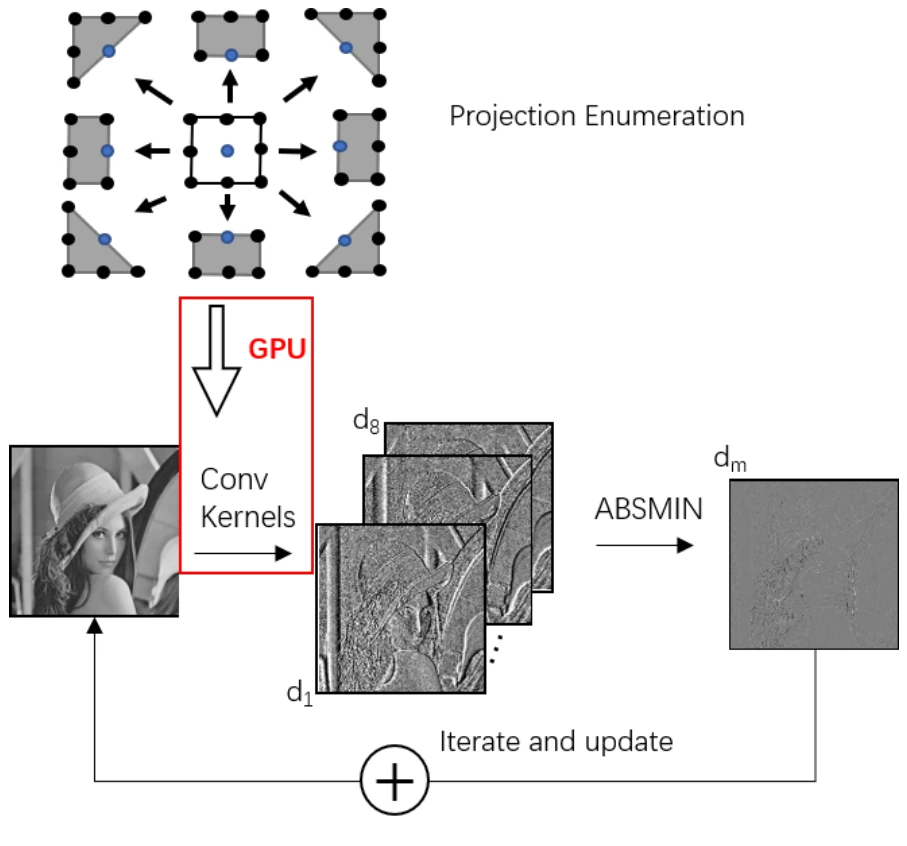
- 把图像看作曲面。 图像灰度 U 被视为定义在像素网格上的曲面。各种曲率正则项都作用于每个像素周围的 3 × 3 局部邻域。
- 8 个切平面投影。 曲面在局部可以用切平面近似。在 3 × 3 邻域内枚举 8 个经过相邻像素的切平面,得到中心像素的 8 个投影距离 d1 … d8。
- 在 GPU 上执行 8 次卷积。 每种距离都以一次图像卷积的形式对所有像素同时计算。这 8 次卷积是算法中计算量最大的部分;PCF 用 CUDA 实现它们,并借助 GPU 的共享内存加速。
- 选取最小距离并更新。 对每个像素,选出绝对值最小的距离 dm(ABSMIN),并将其加到该像素上:Ut+1 = Ut + dm。最小距离意味着该像素最接近期望的几何形态,同时与原始图像拟合得最好。
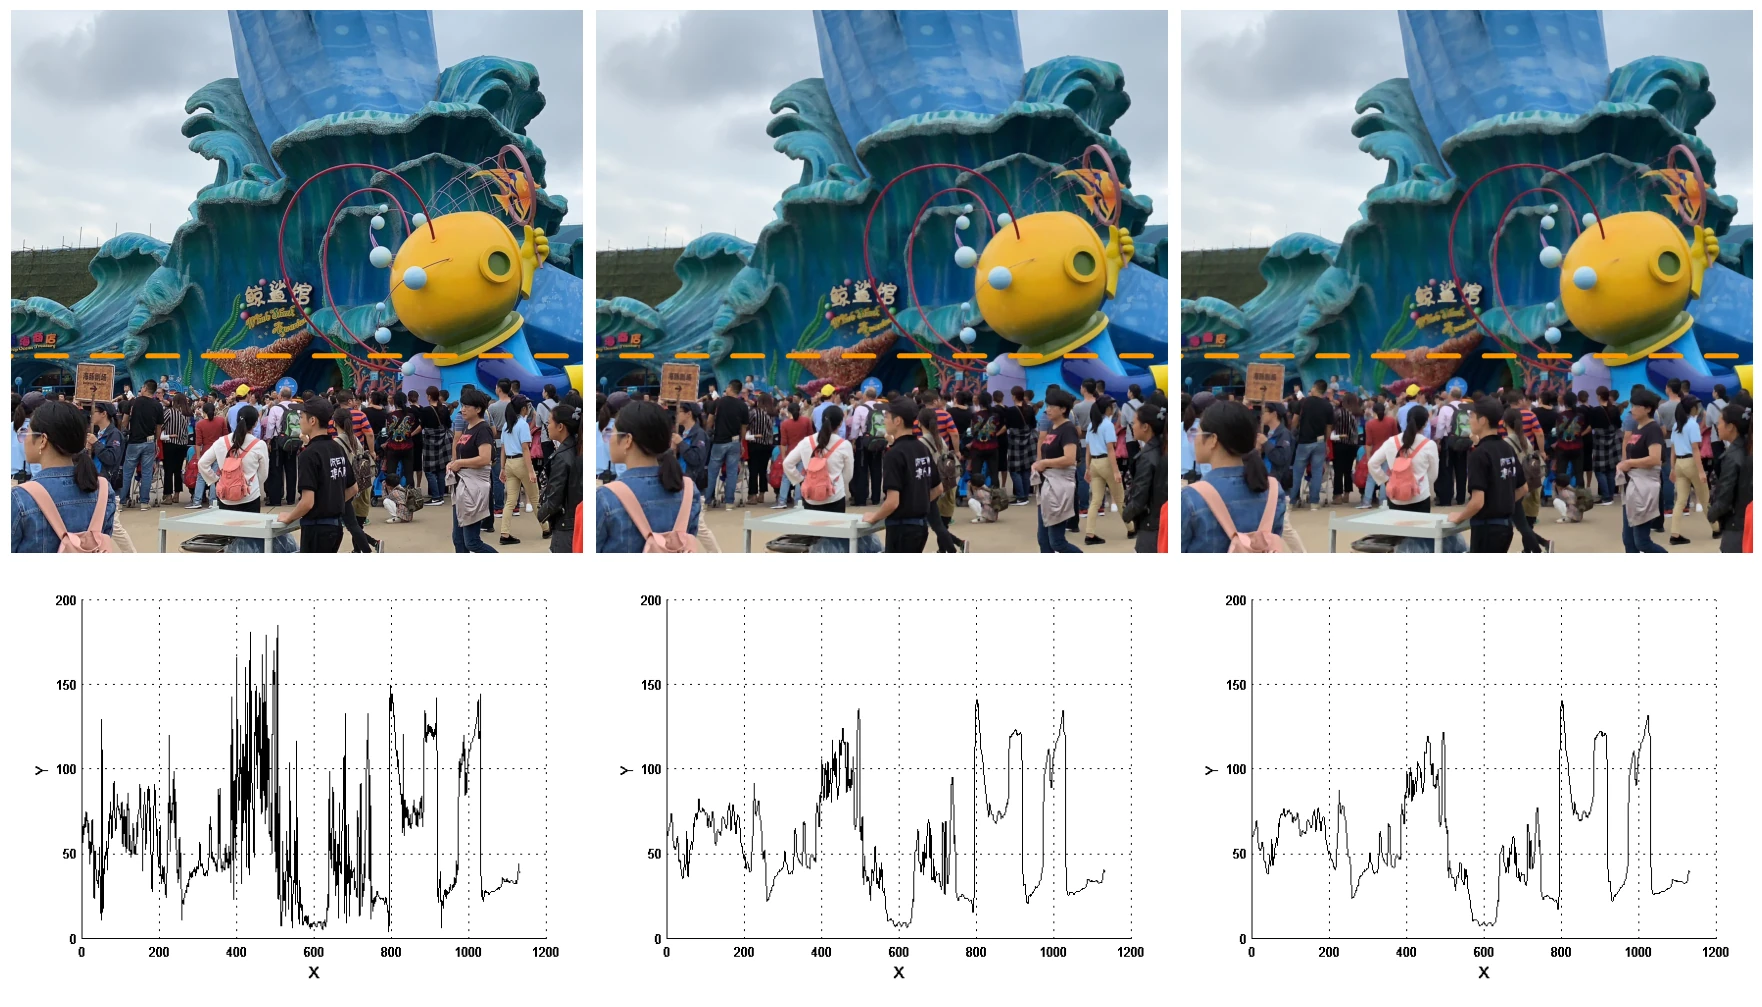
- 迭代。 反复执行这一更新,图像曲面便逐步得到正则化;论文通过绘制图像中一条直线上经 10 次和 30 次迭代后的灰度分布展示了这一过程。
实验结果
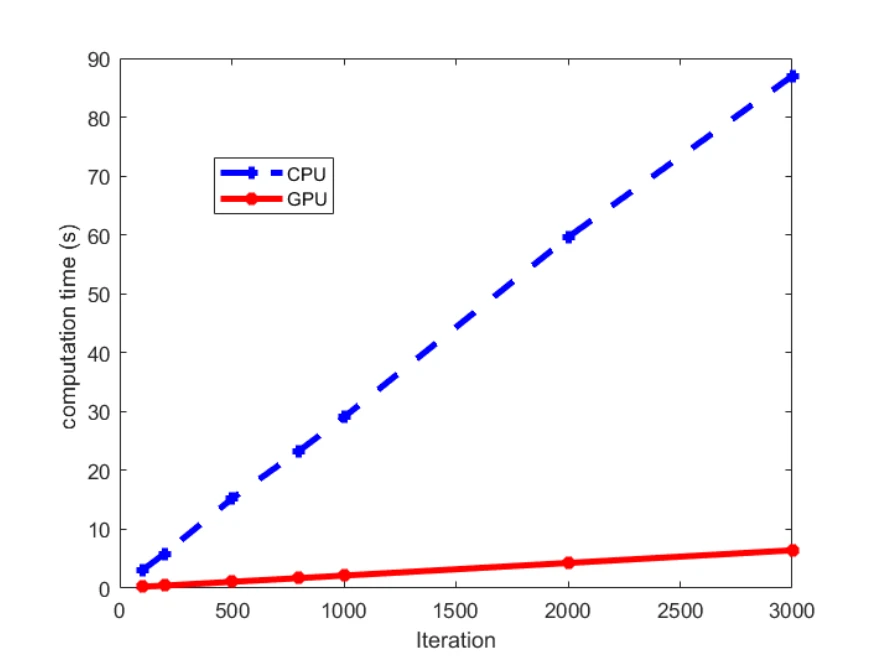
PCF 的 CUDA 实现在 GPU 线程块大小为 16 到 32 的设置下运行,所用 GPU 为 NVIDIA GeForce GTX 1080 Ti(3584 个 CUDA 核心、11264 MB 全局内存、每个线程块 49152 字节共享内存),对比对象是在 Intel Xeon E5-1620 v4(3.50 GHz)CPU 上运行的原始曲率滤波。图 3 中,两者的计算时间都随迭代次数增长,但 GPU 上的增长要慢得多。作者据此认为,这样的速度使曲率滤波可以用于视频处理、生物医学图像处理等实时应用。
论文还将高斯曲率和平均曲率两种 PCF 应用于一张照片,并绘制图中一条直线上经 10 次和 30 次迭代后的灰度分布。两种方法下,灰度剖面都随迭代次数增加而变得更平滑;作者根据这些剖面认为,平均曲率 PCF 的平滑效率高于高斯曲率 PCF(比较的是平滑效果,而非运行时间)。
引用
@inproceedings{pan2019parallel,
  title={Parallel curvature filter for high performance image processing},
  author={Pan, Wei and Gong, Yuanhao and Qiu, Guoping},
  booktitle={International Workshop on Advanced Image Technology (IWAIT) 2019},
  volume={11049},
  pages={282--287},
  year={2019},
  organization={SPIE},
  doi={10.1117/12.2520823}
}