Robust Object 6D Pose Estimation Under High Dynamic Ambient Light
一句话看懂强烈且不均匀的光照会在反光物体上造成高光和阴影,使 Gen6D 位姿估计失准。在其 VGG 骨干网络中加入高效通道注意力后,GenMOP 数据集上的精度提升,推理时间增加 35.7 ms。
问题背景
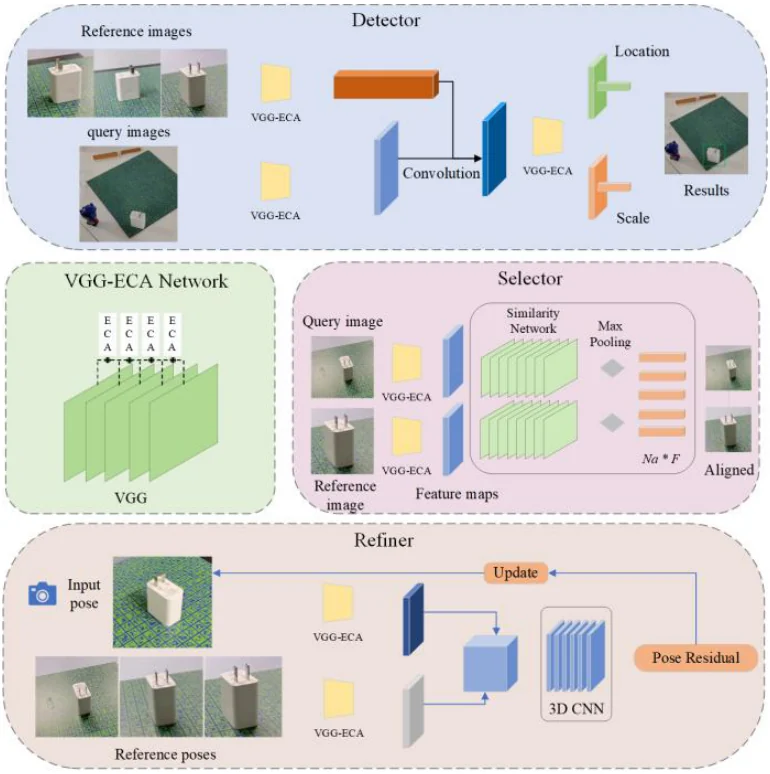
物体 6D 位姿估计是指求出物体相对于相机的三维旋转和平移,本文的输入是单张 RGB 图像。Gen6D 是一种无需物体模型的位姿估计器:测试时不需要高质量的物体模型、深度图或物体掩码,而是借助物体的参考图像完成估计。它分三个阶段:检测器定位物体并估计其尺寸,选择器挑出最相似的参考图像得到粗略旋转,精化器再对估计结果进行修正。
在高动态环境光下,高光与阴影之间反差强烈,这一流程便难以奏效。物体表面的反射随光照变化,阴影改变表面的亮度和纹理,颜色也会失真。作者用投射光源人为制造高动态光照场景,使物体表面反光不均,结果 Gen6D 的位姿估计效果很差。精化器往往难以单独弥补,因为它高度依赖前两个阶段给出的粗略估计,而这些估计已经受到光照的影响。
方法原理
该方法保留 Gen6D 的"检测器—选择器—精化器"流程,改动的是三个阶段共用的特征提取网络:在 VGG 骨干网络中嵌入高效通道注意力(ECA)模块。由此得到的 VGG-ECA 网络会增强信息丰富的特征通道、削弱噪声通道,使特征受高光和阴影的干扰更小。
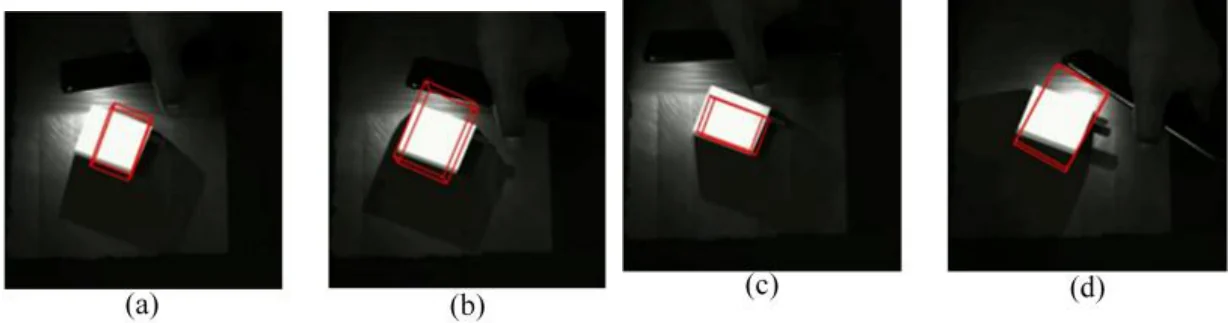
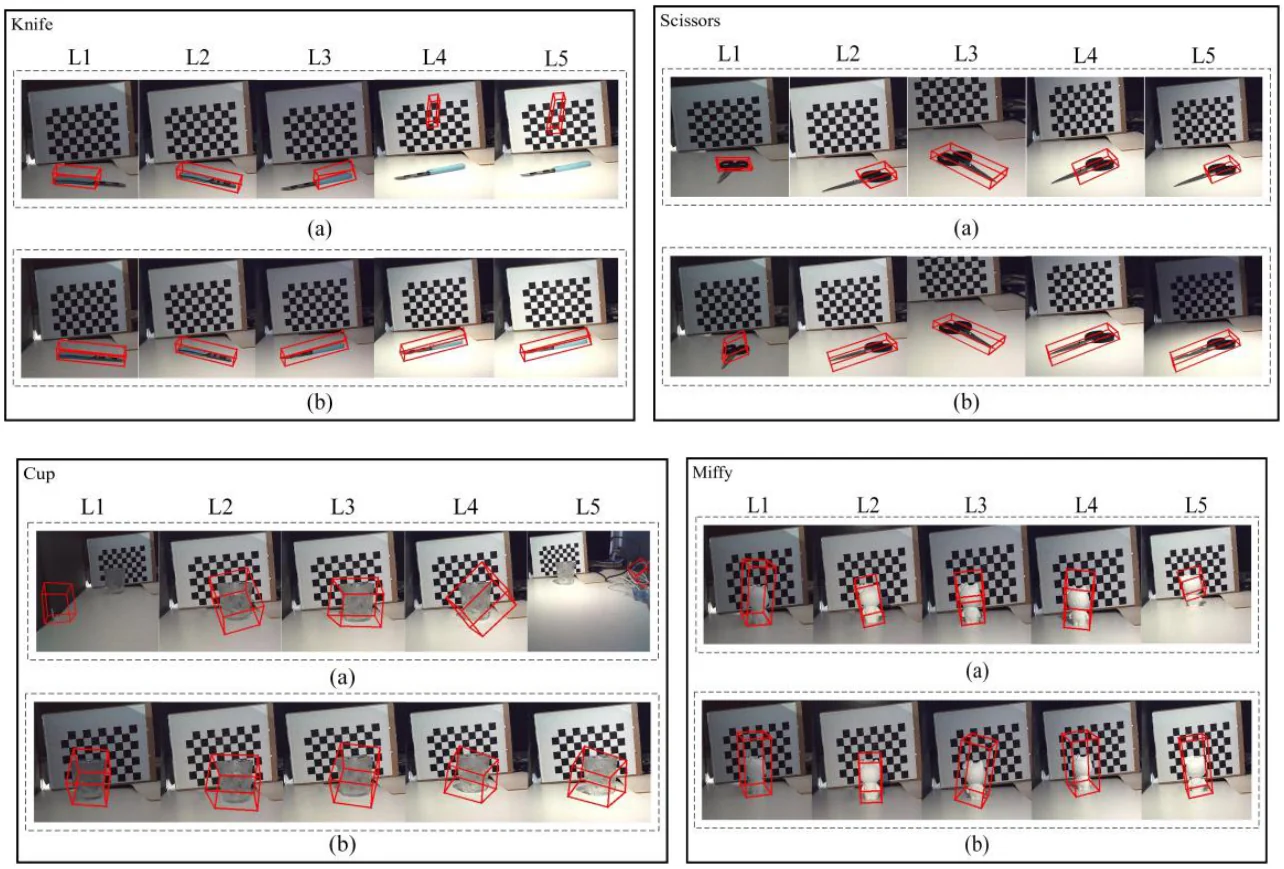
- 高光让原模型失效。 对于带金属部件的物体(如刀、剪刀),Gen6D 往往只识别出反光较弱的塑料手柄,而漏掉强反光的金属部分。
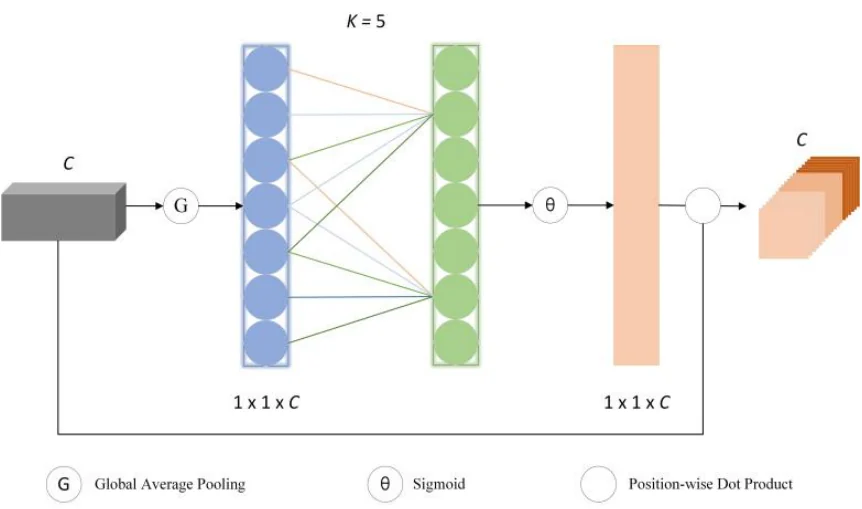
- 在骨干网络中加入通道注意力。 在 VGG 中 64、128、256 个滤波器的卷积层之后加入 ECA 模块。每个模块先把各通道平均为一个数值,再沿相邻通道做一维卷积(卷积核大小由通道数自适应确定),经 Sigmoid 映射为 0–1 之间的权重,最后与各通道相乘。与其所基于的挤压激励(SE)模块不同,ECA 不需要先降低通道维度。
- 检测器。 以参考图像的 VGG-ECA 特征为卷积核,在若干预设尺度上与查询图像的特征做卷积。所得热图的峰值即物体中心的二维投影,尺度图在该处的取值给出包围框尺寸,由此得到深度和初始平移。
- 选择器。 将物体区域与各参考图像比较,最相似的一张给出初始旋转。
- 精化器。 3D CNN 回归当前位姿与真实位姿之间的残差,并据此更新估计。
实验结果
模型在 Gen6D 的官方数据集 GenMOP(共 10 个物体)上训练,测试时作者专门挑选了表面反光强的物体。ADD-0.1d 统计模型点与真值之间的平均距离小于物体直径 10% 的位姿所占比例;Prj-5 统计二维投影误差小于 5 像素的位姿所占比例。表 1 中的七个物体上,改进模型在两项指标上均高于 Gen6D。
在高动态环境光下另行采集的 RGB 图像直观地展示了效果。Gen6D 只框住了刀和剪刀的塑料手柄,改进模型则能捕捉物体的整体位姿;对于透明的玻璃杯,Gen6D 检测失败,改进模型则成功检测出其位姿。在由暗到亮的五个光照等级(L1–L5)下,Gen6D 对刀和剪刀的估计在低光(L1、L2)和强光(L4、L5)下都明显变差,而改进模型更为准确,玻璃杯上的提升尤为明显。作者也报告了失败情况:强光使部分刀身在图像中呈黑色,改进模型无法检测这些刀身部分的位姿;金属剪刀在 L1、L2 下仍有错位。作者提出,未来工作包括扩展到更多物体和数据集、尝试其他注意力机制,以及在实际工业应用中进行测试。
引用
@article{lu2026robust,
  title={Robust Object 6D Pose Estimation Under High Dynamic Ambient Light},
  author={Lu, Lei and Zhu, Jiahe and Pan, Wei and Zhang, Haojun and Su, Zhilong and Zhang, Qinghui and Zheng, Wanxing and Gao, Ge and Li, Peng},
  year={2026},
  doi={10.14733/cadaps.2026.411-427}
}