Few-Shot 6D Object Pose Estimation via Decoupled Rotation and Translation with Viewpoint Encoding
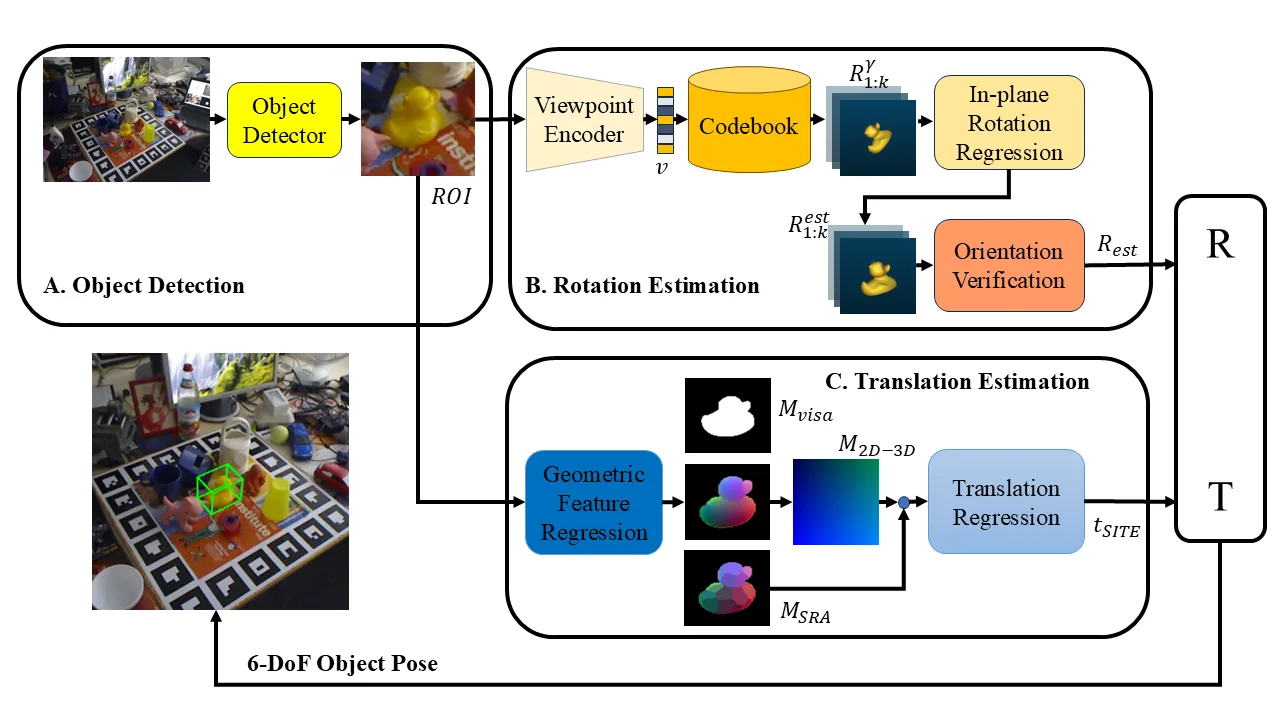
一句话看懂旋转只用合成渲染图学习,平移每个物体只需 600 张真实图像;这一解耦网络从单张 RGB 图像估计物体 6D 位姿,对真实标注图像的依赖大大降低。
问题背景
6D 位姿估计要求出物体相对相机的三维旋转和三维平移,是机器人抓取、自动驾驶和增强现实中的关键环节。深度传感器易受噪声、遮挡和成本的影响,在反光或透明物体上也存在局限,因此仅依赖单张 RGB 图像的方法受到关注。基于关键点、模板或直接回归的单目方法不断进步,但都严重依赖大规模真实标注数据,真实位姿标注的稀缺限制了其进一步提升。
本文将旋转与平移解耦:旋转只用合成图像学习,因此只有平移部分需要用真实图像训练,而且平移网络无须从这些图像中学习旋转信息,从而减少了所需的真实样本数量。
方法原理
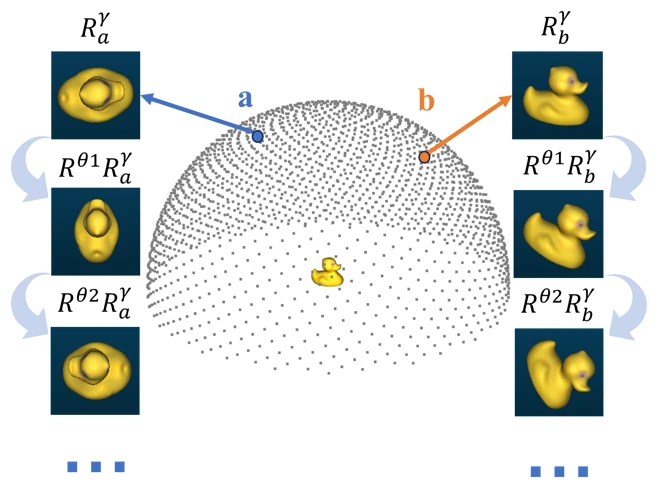
首先由目标检测器从图像中裁剪出物体,随后旋转和平移由两个相互独立的分支分别估计。旋转分支把完整旋转 R 分解为平面外部分 Rγ(物体的视角)和平面内部分 Rθ(绕相机光轴的旋转),即 R = RθRγ,两部分都由仅用合成图像训练的模块处理。平移分支以 GDR-Net 为基础,是唯一用真实图像训练的部分。
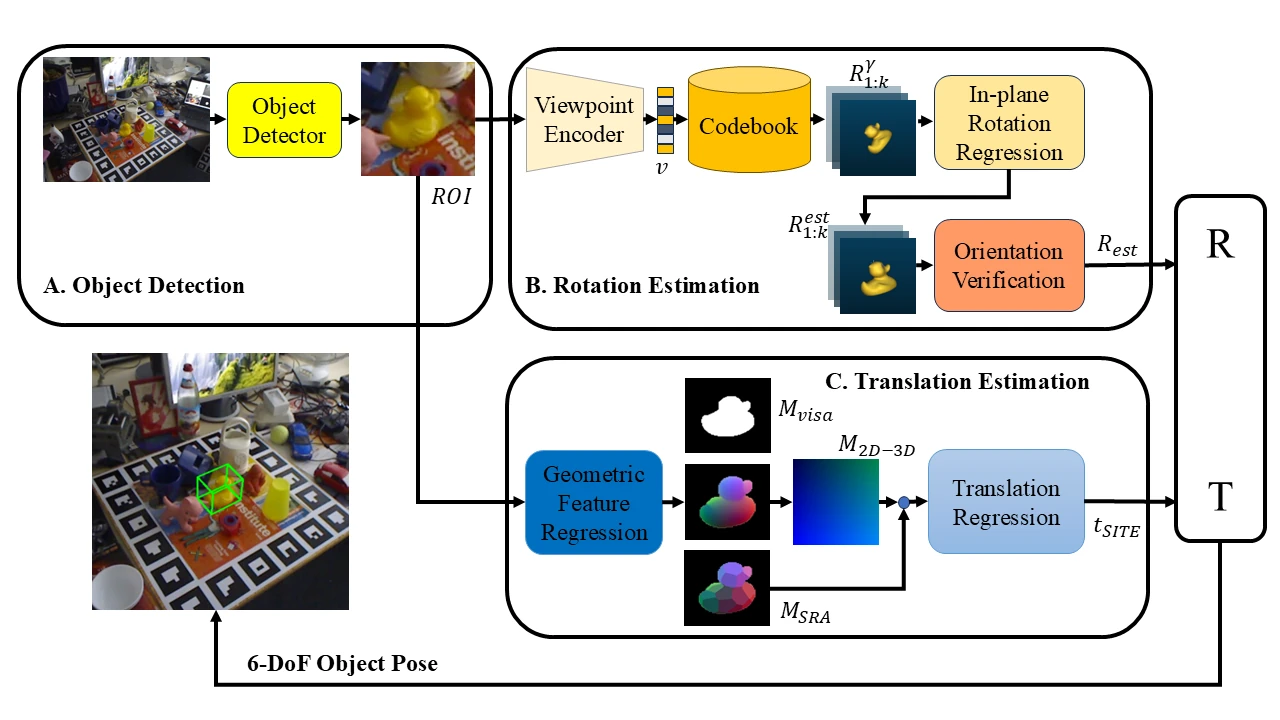
- 检测与裁剪。 目标检测器从 RGB 图像中提取物体周围 128×128 的感兴趣区域(ROI),两个分支都以该区域为输入。
- 检索候选视角。 视角编码器在由 ShapeNet 渲染的图像上训练,把 ROI 映射为 64 维向量;该向量对视角变化敏感,而对平面内旋转保持不变。对目标物体,在其网格模型周围的球面上均匀采样 4,000 个视角并渲染,构建视角码本;与码本计算余弦相似度,得到前 K 个候选视角。
- 回归平面内旋转。 对每个候选视角,回归头比较 ROI 与该视角下的渲染图,预测平面内旋转,得到一个完整的三维旋转假设。
- 姿态验证。 验证头为每个假设计算与 ROI 的一致性分数,得分最高的假设作为旋转估计结果。
- 回归平移。 沿用 GDR-Net 的设计,ResNet-34 从 ROI 预测三幅 64×64 的特征图(稠密 2D–3D 对应图、表面区域注意力图和可见物体掩膜),再由轻量网络根据对应图和表面区域注意力图回归尺度不变的平移参数。该分支每个物体用 600 张真实图像训练。
实验结果
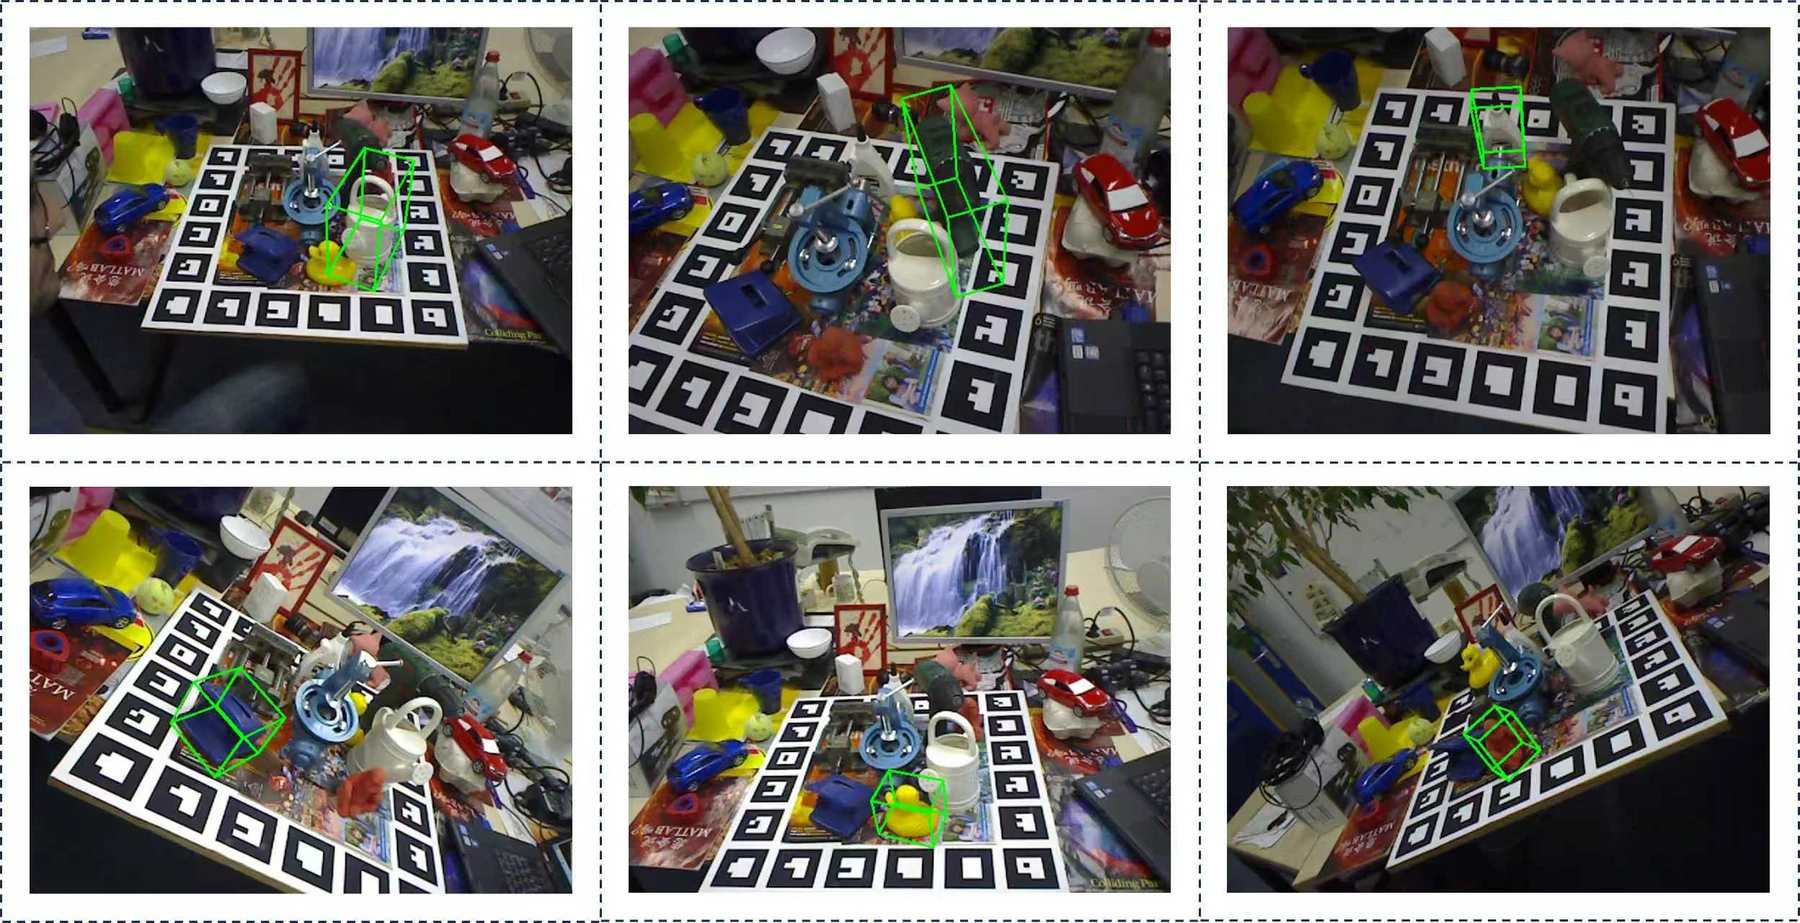
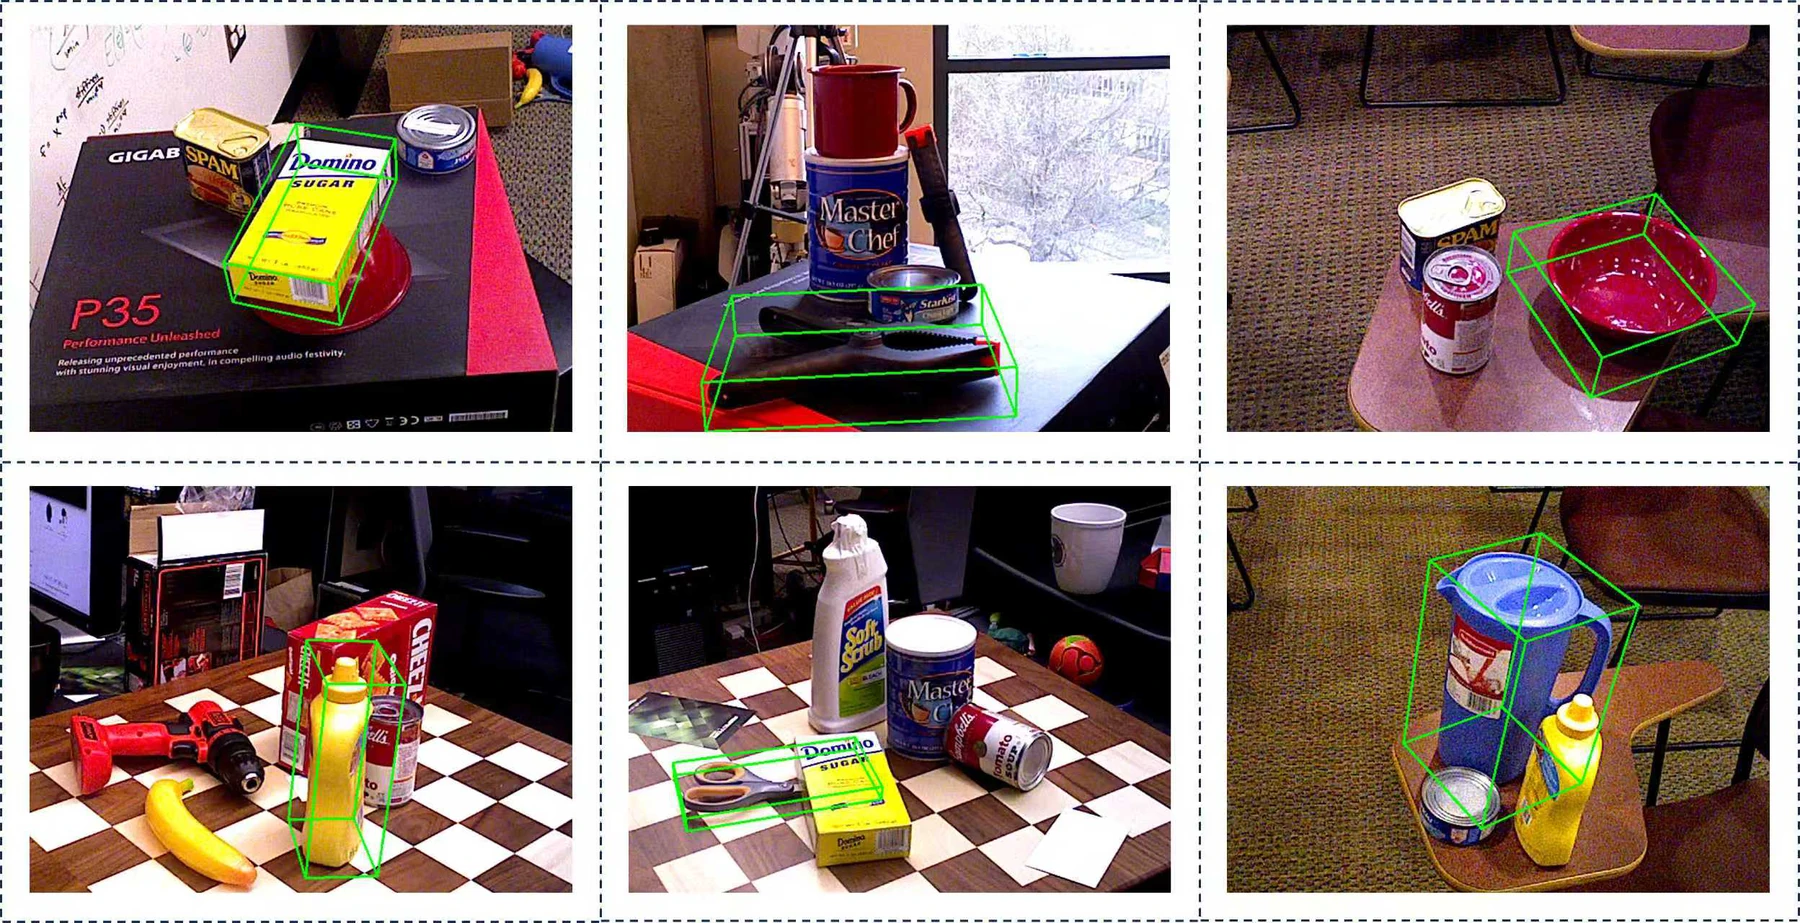
实验使用 LINEMOD(杂乱场景中的 13 个物体)、LM-O(8 个部分遮挡的物体,1,214 张测试图像)和 YCB-V(21 个物体,遮挡严重,且包含多个对称物体)。当 ADD(-S) 误差小于物体直径的 10% 时,位姿判为正确;在 YCB-V 上还报告了阈值上限为 10 cm 的 ADD(-S) 曲线下面积(AUC)。旋转网络只用合成图像训练,平移网络每个物体使用 600 张真实图像;在 YCB-V 上,训练还额外使用了基于物理渲染(PBR)的图像。
在 LM-O 上,该方法在大多数物体上领先于对比方法,相对 GDR-Net 提升最大的是 Holepuncher(74.5% 对 60.1%)、Duck 和 Ape;在 Can 和 Eggbox 上,GDR-Net 仍略高。在 YCB-V 上,该方法的 AUC of ADD(-S) 也领先,为 86.9%,GDR-Net 为 84.4%。小样本对比的差距最为明显:用同样 600 张真实图像重新训练 ZebraPose 和 CheckerPose 后,它们在 YCB-V 上的 ADD(-S) 降至 35.7% 和 37.8%,而本方法为 65.9%(表 6)。论文还在 LINEMOD 上单独评估了旋转各模块:在真实图像、预测 ROI 条件下,视角检索误差在 10° 以内的比例为 72%;平面内旋转误差在 10° 以内的比例,在使用预测视角和预测 ROI 时为 74%,使用真值视角时超过 90%(图 5、图 6),可见平面内旋转精度在很大程度上取决于视角检索的质量。作者指出,该方法的精度部分依赖目标检测器的可靠性,对未见物体类别的泛化能力仍然有限。
引用
@article{lu2026few,
  title={Few-Shot 6D Object Pose Estimation via Decoupled Rotation and Translation with Viewpoint Encoding},
  author={Lu, Lei and Cao, Peng and Pan, Wei and Su, Zhilong and Zhang, Haojun and Zheng, Wangxing and Gao, Ge and Li, Peng},
  journal={Electronics},
  volume={15},
  number={3},
  pages={561},
  year={2026},
  publisher={MDPI},
  doi={10.3390/electronics15030561}
}