VeinTr: Robust end-to-end full-hand vein identification with transformer
一句话看懂VeinTr 直接从整只手的近红外图像识别身份,无需裁剪手掌:CNN 加轻量 Transformer 读取完整的静脉纹路,在 CASIA(多光谱掌纹图像库)上的正确识别率达到 99.92%。
问题背景
手部静脉识别利用近红外光下成像的手部静脉纹路来识别身份。典型系统包括四个步骤:定位手部、提取感兴趣区域(ROI)、从 ROI 中提取特征,再与数据库中已注册的手进行比对。早期方法依赖手工设计的几何或统计描述子,在光照变化、噪声等扰动下表现欠佳;近年的方法则改用卷积神经网络学习特征。
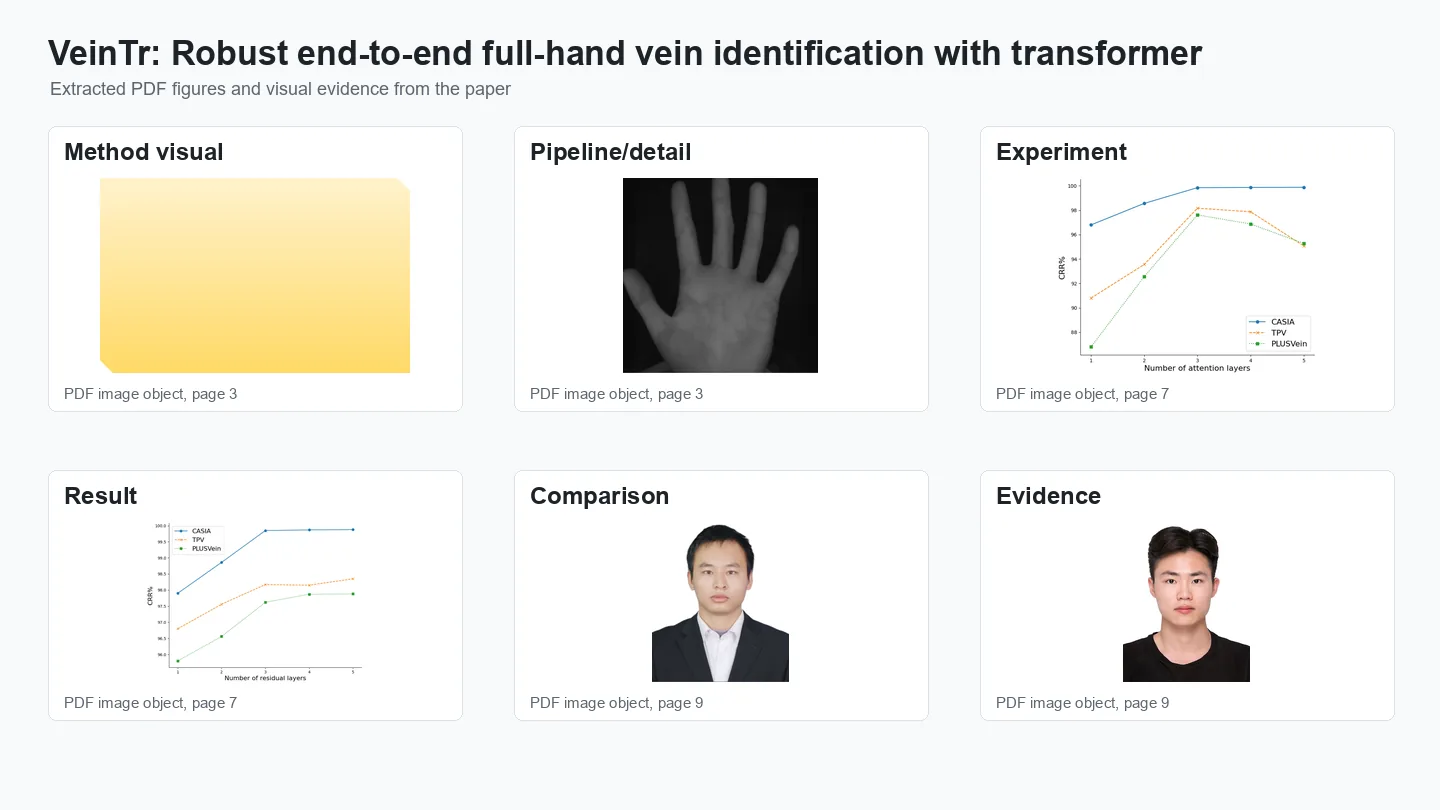
然而,即便是基于学习的方法,仍然只在 ROI 上工作,通常是从手掌上裁出的区域。这带来两个问题:一是预处理流程复杂,识别精度取决于 ROI 提取是否稳健,而这在实际应用中并不容易;二是裁剪会丢失信息——整只手的静脉纹路对每个人都是独一无二的,只用其中一部分构建的特征表示,可能不如利用完整纹路的表示。
方法原理
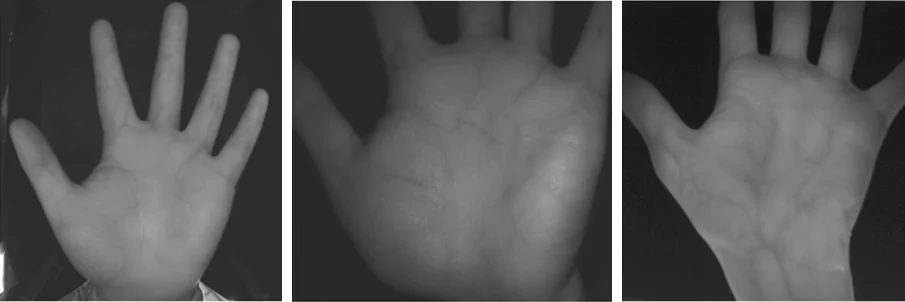
VeinTr 省去 ROI 提取,直接以整幅手部图像为输入,识别过程只有特征提取和待测样本–数据库匹配两步。特征提取网络由卷积局部特征编码器、轻量 Transformer 和基于 MLP 的全局特征解码器组成,整个网络作为度量学习任务进行端到端训练。
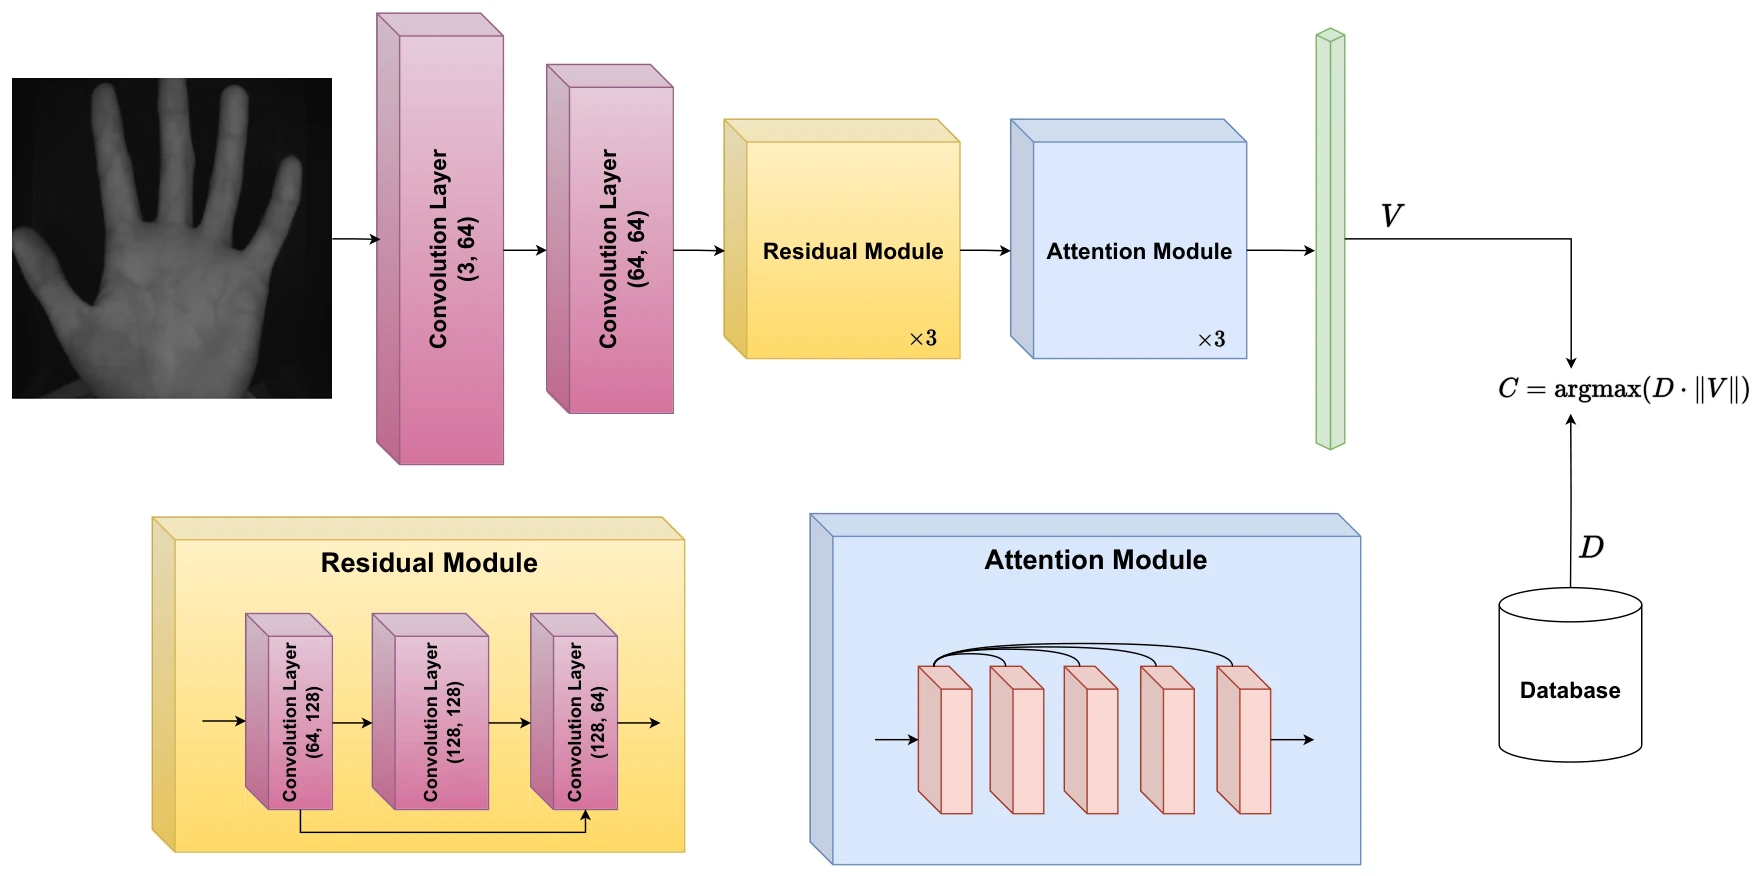
- 不裁剪 ROI。 传统流程先定位手部、裁出手掌 ROI 再提取特征,ROI 以外的静脉信息随之丢失;VeinTr 则直接输入整只手的图像。
- 提取局部特征。 卷积块(卷积、批归一化和 PReLU)在提取局部特征的同时缩小 256×256 的输入,再经三个残差块增强,得到 64×64×64 的局部特征图。
- 用注意力聚合全局信息。 特征图被切分为 16 个 16×16 的图块,展平后投影到较低维度。三层 8 头的多头注意力让每个图块与其余所有图块建立关联,把感受野从局部扩大到整只手。
- 每只手一个特征向量。 全局特征解码器将注意力输出展平,经过带批归一化的两层 MLP,得到 512 维的手部静脉特征。训练采用 ArcFace 损失,使同一只手的特征彼此接近、不同手的特征相互区分。
- 待测样本–数据库匹配。 已注册手的归一化特征组成数据库矩阵 D;待测手被判为相似度得分最高的身份 C,即 C = argmax(D · ‖VeinTr(p)‖),其中 ‖·‖ 表示归一化。
实验结果
对比方法均基于手掌或手指 ROI,只有 VeinTr 使用整只手。在 CASIA 上,所有手工特征方法的正确识别率都已超过 90%,此前的 NAF 方法更是接近饱和,达到 99.83% 和 99.50%,因此 VeinTr 在正确识别率上的领先幅度不大(0.02 和 0.42 个百分点);等错误率则比 NMRT 低 0.41 个百分点,比 PVSNet 低 3.61 个百分点(表 1)。跨数据集实验中,VeinTr 分别在一个数据集上训练,再在全部三个数据集上测试。在 CASIA 或 TPV 上训练的模型,在每个测试集上的正确识别率都超过 90%。PLUSVein 规模小得多(42 名志愿者的 420 幅图像),在其上训练的模型泛化能力较弱,在 CASIA 和 TPV 上分别为 89.76% 和 81.43%。
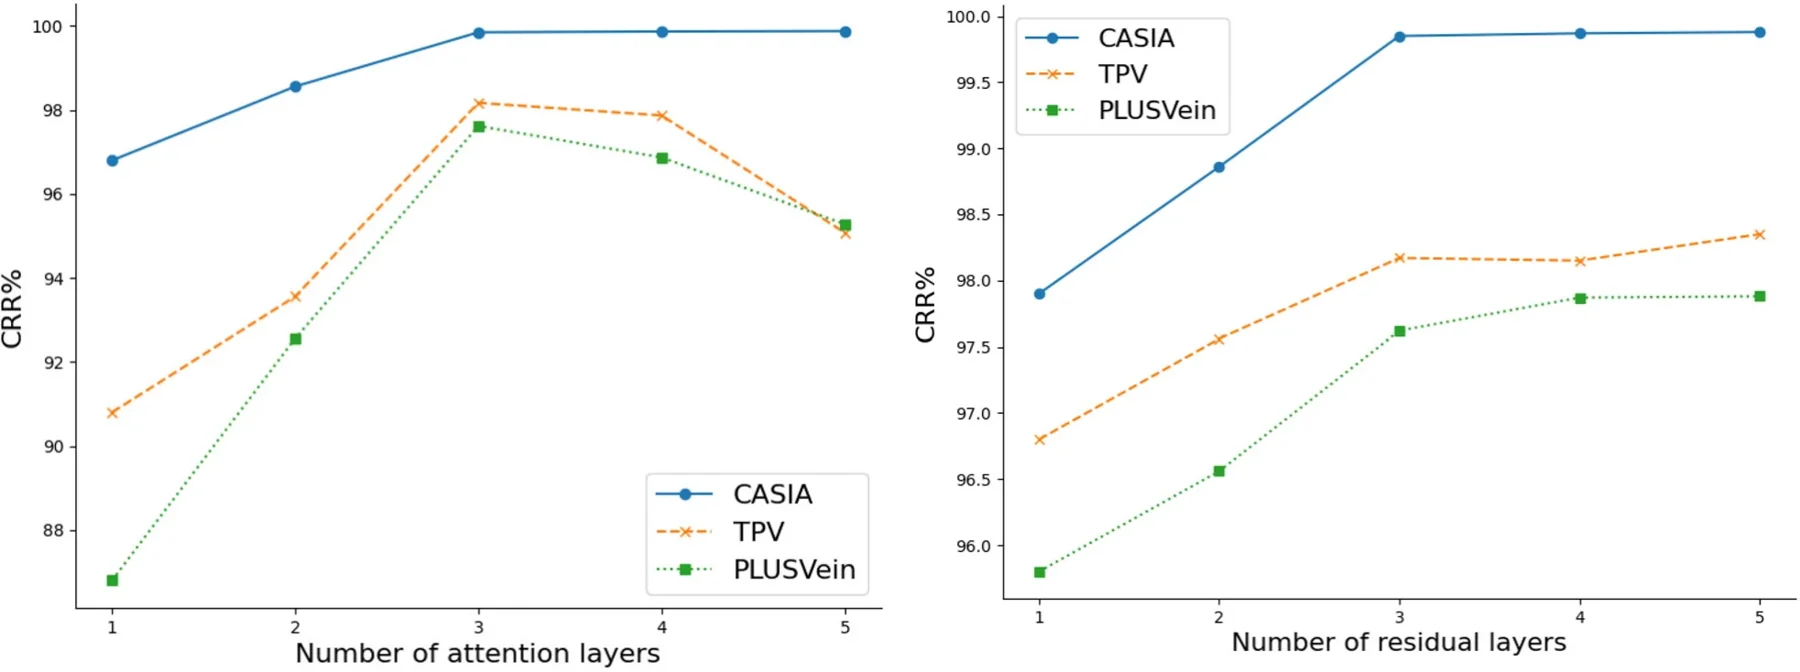
消融实验(所有模型均在 CASIA 上训练)表明,网络的两个部分都不可或缺。去掉注意力层后,正确识别率在 CASIA、TPV 和 PLUSVein 上分别降至 83.43%、65.14% 和 55.10%;去掉残差块后,分别降至 95.12%、75.07% 和 83.67%(表 3)。注意力层为三层时,CASIA 上的识别率趋于饱和,TPV 和 PLUSVein 上达到最高;增加到第四、第五层后识别率反而下降,作者将其归因于过拟合。残差块取三层,是在识别率与计算开销之间的折中。作者计划在后续工作中把全手静脉信息与全手手纹数据相融合。
引用
@article{lu2024veintr,
  title={Veintr: robust end-to-end full-hand vein identification with transformer},
  author={Lu, Shenglin and Fung, Sheldon and Pan, Wei and Wickramasinghe, Nilmini and Lu, Xuequan},
  journal={The Visual Computer},
  volume={40},
  number={10},
  pages={7015--7023},
  year={2024},
  publisher={Springer Berlin Heidelberg Berlin/Heidelberg},
  doi={10.1007/s00371-024-03286-6}
}