Generative deep-learning-embedded asynchronous structured light for three-dimensional imaging
一句话看懂投影仪与相机不同步时,拍到的图像可能混入两幅条纹图案。生成式网络 APSNet 将其分离,使标准相移法三维成像重新可用,与同步结果的偏差不超过 8 μm。
问题背景
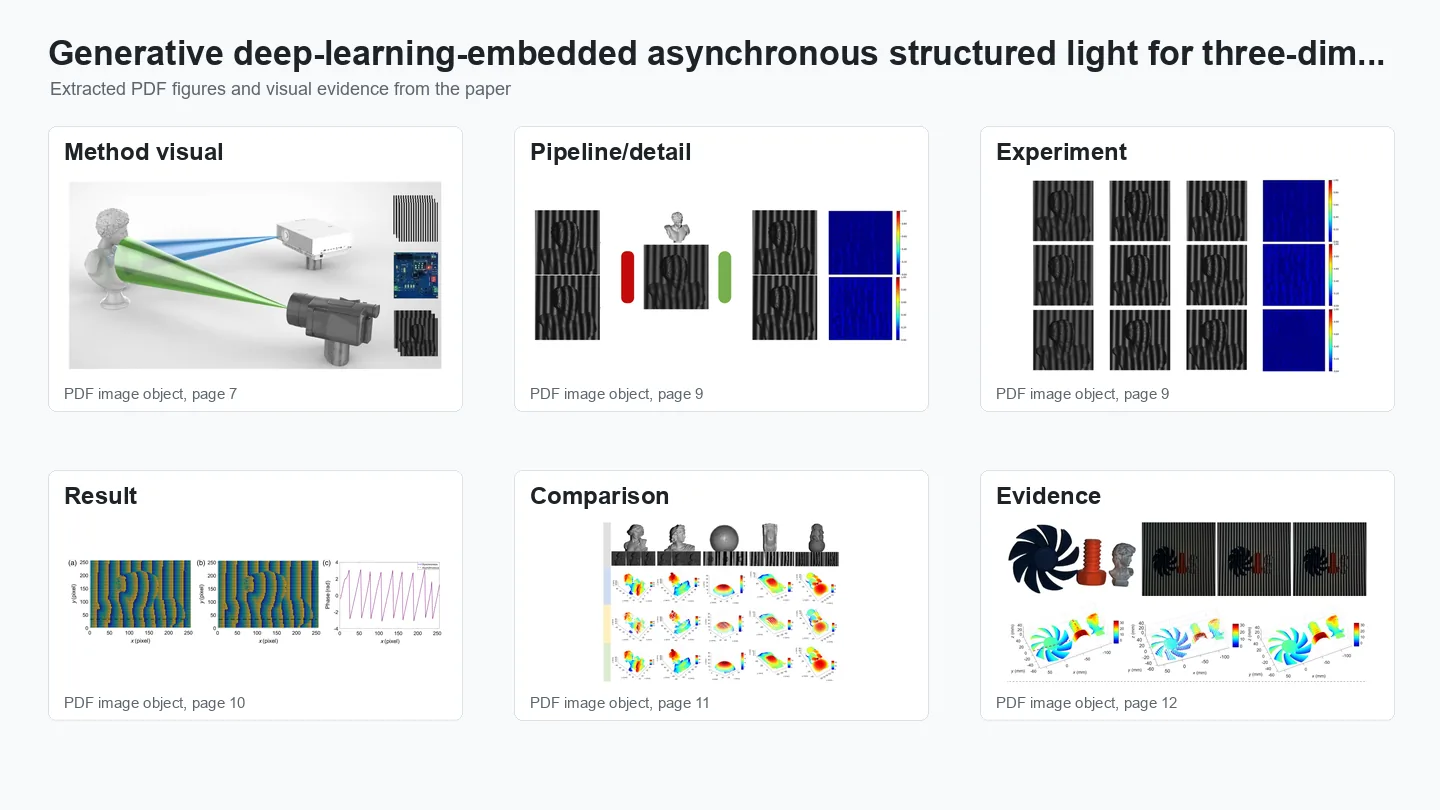
结构光三维测量向物体投射一系列条纹图像,再从另一视角拍摄。物体表面会使条纹发生弯曲,每个像素处的条纹相位编码了深度信息。条纹投影轮廓术(FPP)是这类技术中最常用的方法之一,它要求相机在某一幅图案单独显示期间完成拍摄,因此投影仪与相机之间必须同步,通常依靠硬件触发信号实现。
同步在工程上是一种负担。硬件触发电路只见于昂贵的工业设备,而低成本的消费级设备往往没有相应接口,尽管如今智能手机、平板和笔记本电脑的相机已具备很高的分辨率和帧率。软件同步需要在两幅图案之间等待比曝光时间更长的间隔,帧率因此降低,而且并不总能稳定工作。信号线还限制了相机与投影仪之间的距离,并容易受到电磁干扰。然而,如果投影仪和相机各自独立运行,投影仪就可能在相机曝光中途切换图案,拍到的图像便是相邻两幅图案的混合,即混叠条纹图(aliased fringe pattern,AFP)。直接从这类图像计算相位会导致重建误差。已有的非同步结构光研究使用的是简单的二值(黑白)图案,或只处理了异步问题的其他方面;据作者所知,此前尚无针对广泛使用的正弦条纹进行异步采集的研究。
方法原理
混叠本身的形式很简单。AFP 中每个像素的值,是曝光期间两幅图案各自贡献的累加,两者所占比例取决于投影仪切换图案的时刻(论文式 5)。混叠不会移动像素,在每个位置都以相同方式发生,这一性质正适合用卷积网络来处理。但切换时刻未知,且很难测量,因此从一幅图像恢复出两幅图像是一个病态的“一对多”问题。论文将其视为图像生成问题:由生成式网络学习生成两幅干净的条纹图,之后即可直接沿用标准的相移重建方法。
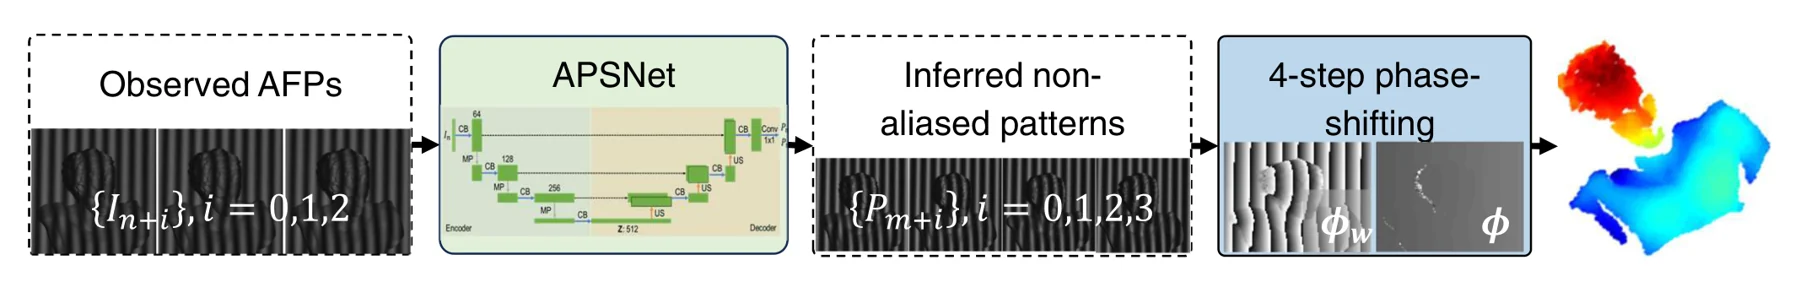
- 同步采集(参照)。 每次曝光恰好只看到一幅投影图案,因此每张图像只包含一幅干净的条纹图。
- 异步采集。 投影仪和相机各以恒定速度工作,且相机速度更快,以保证每幅图案都能被拍到。若图案切换发生在曝光期间,就会得到一幅对相邻两幅图案积分而成的 AFP。论文处理的是两幅图案混叠的情形。
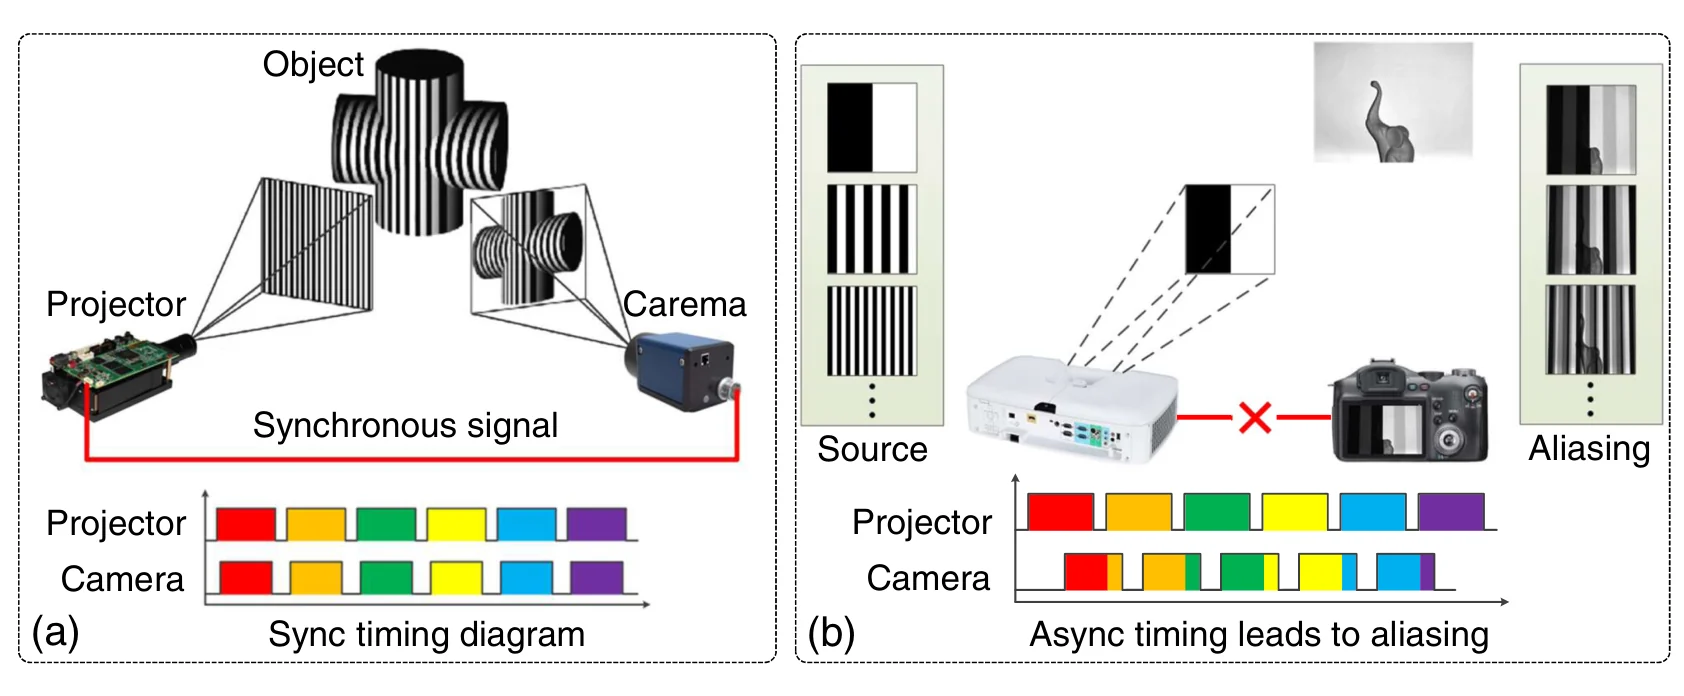
- 用 APSNet 分离。 APSNet(混叠条纹图分离网络)是基于 U-Net 的编码器–解码器:编码端由四个带最大池化的模块组成,解码端通过上采样和跳跃连接逐步恢复到原始分辨率。它把一幅 AFP 映射为混叠前的两幅图案。训练时,APSNet 作为条件生成对抗网络(GAN)中的生成器:判别器将生成的图案对与真实图案对进行比较,另有均方误差和结构相似性两项损失,使生成图案在统计上接近投影图案。对抗、均方误差和结构相似性三项损失权重相等时,训练过程最为平稳(图 8)。
- 求相位。 每幅 AFP 混入相邻两幅图案,相邻的三幅 AFP 与前后相邻者共享图案,因此 APSNet 可得到四幅相继的条纹图,相邻两幅相差四分之一周期。经典的四步相移算法由此求出包裹相位,再加上条纹级次(2π 的整数倍)完成相位展开,得到连续相位图。
- 三维形貌。 利用成熟的 FPP 重建模型,由连续相位计算出物体的三维形貌。
训练数据来自真实系统:一台工业相机(2048 × 1536 像素)、一台 DLP 投影仪(1280 × 1024)和一块自研微控制器:投影仪投射条纹后向微控制器发出信号,后者按设定时长 Δt 延迟触发相机。Δt = 0 时,系统采集到的是普通的无混叠条纹。源图案为五组 256 × 256 的正弦条纹,周期数分别为 50、60、70、80、90,每组包含四个相移(0、0.5π、π、1.5π),采集时延迟从 1 ms 到 10 ms,以 1 ms 递增。由此得到 1500 幅 AFP,每幅都与其两幅源图案配对,其中 1125 幅用于训练,375 幅用于测试。
实验结果
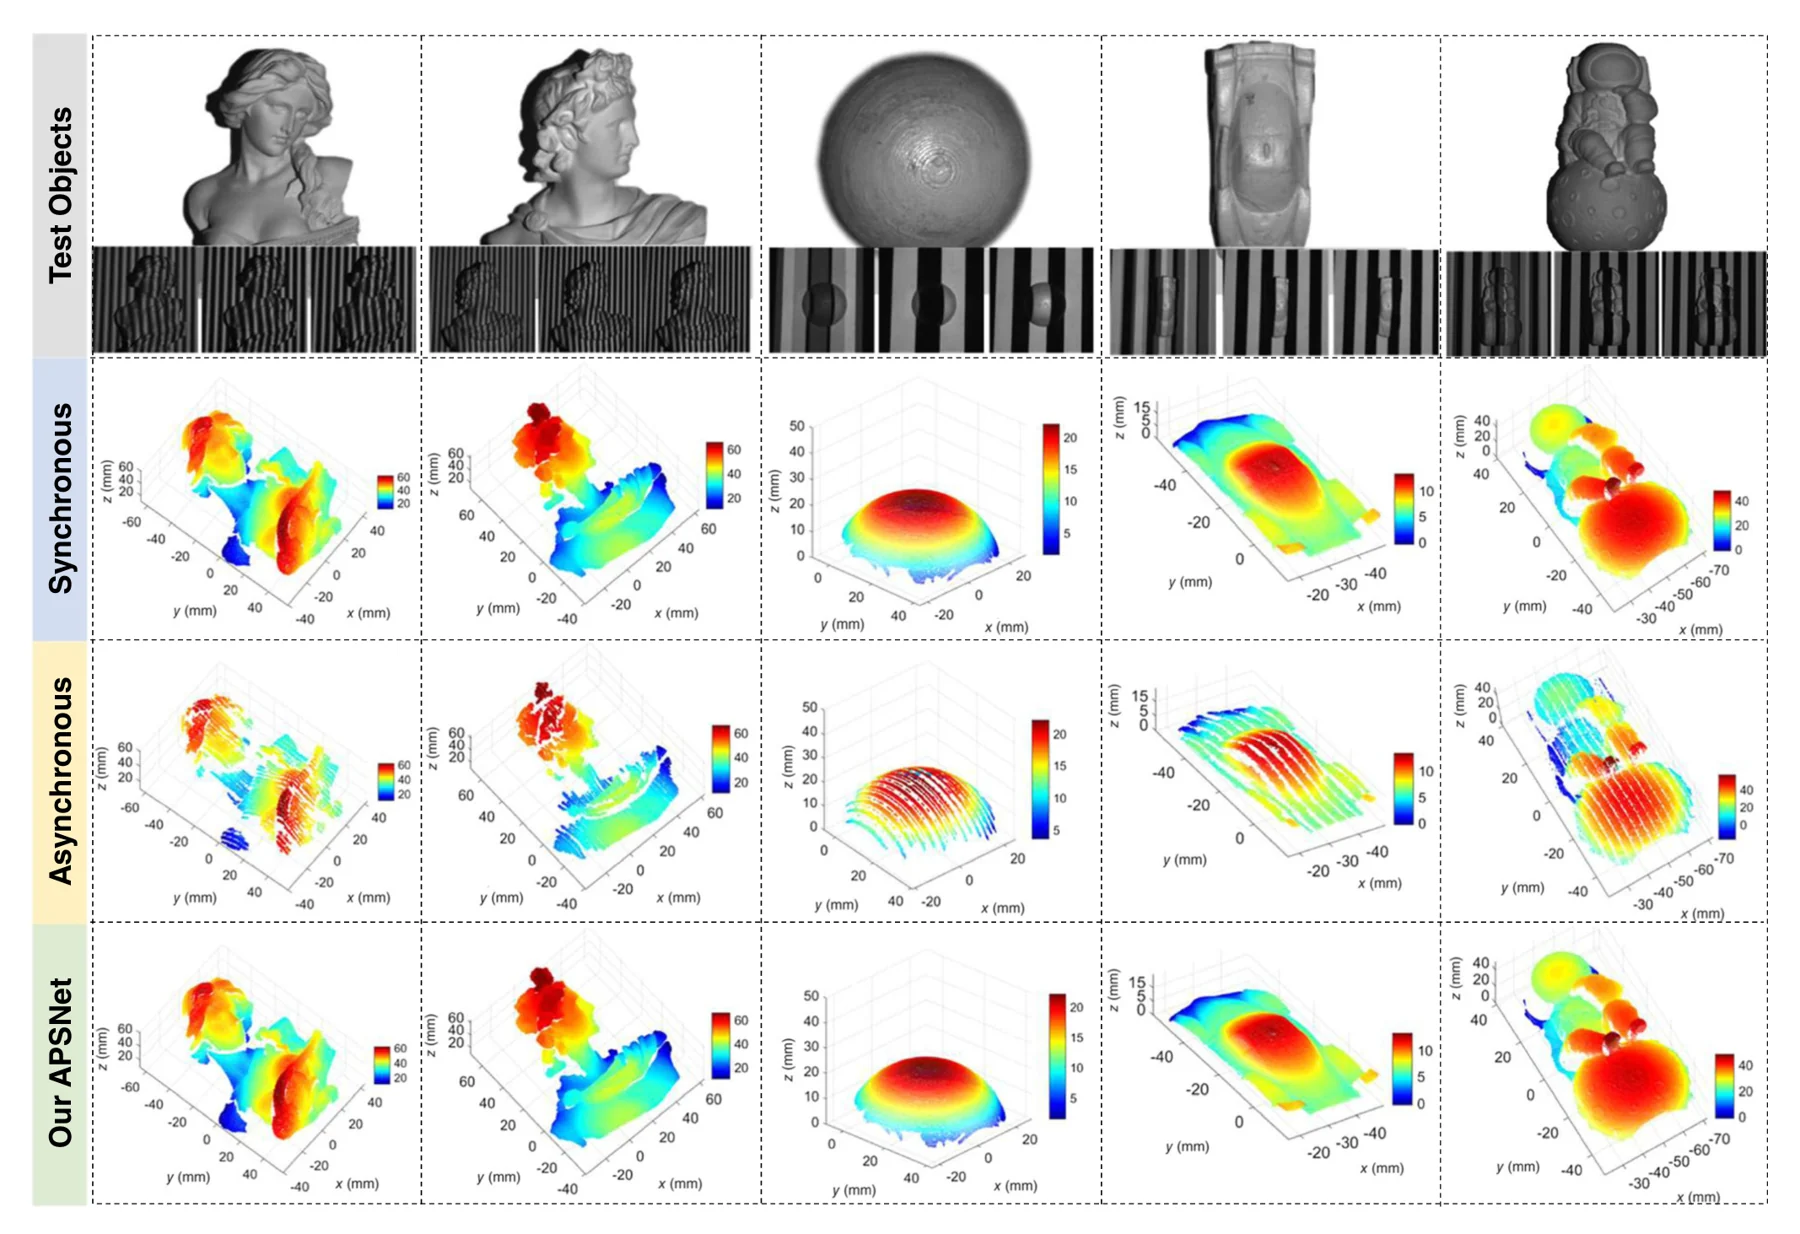
测试对象包括雕像、汽车模型和球体,网络在训练和验证中都没有见过它们。所有对比都以同步图案的重建结果为基准。直接用 AFP 重建会丢失大量形状信息,而用 APSNet 分离出的图案重建的形状与基准非常接近(图 12)。论文总结指出,相比直接使用混叠条纹,重建精度提高了三个数量级。
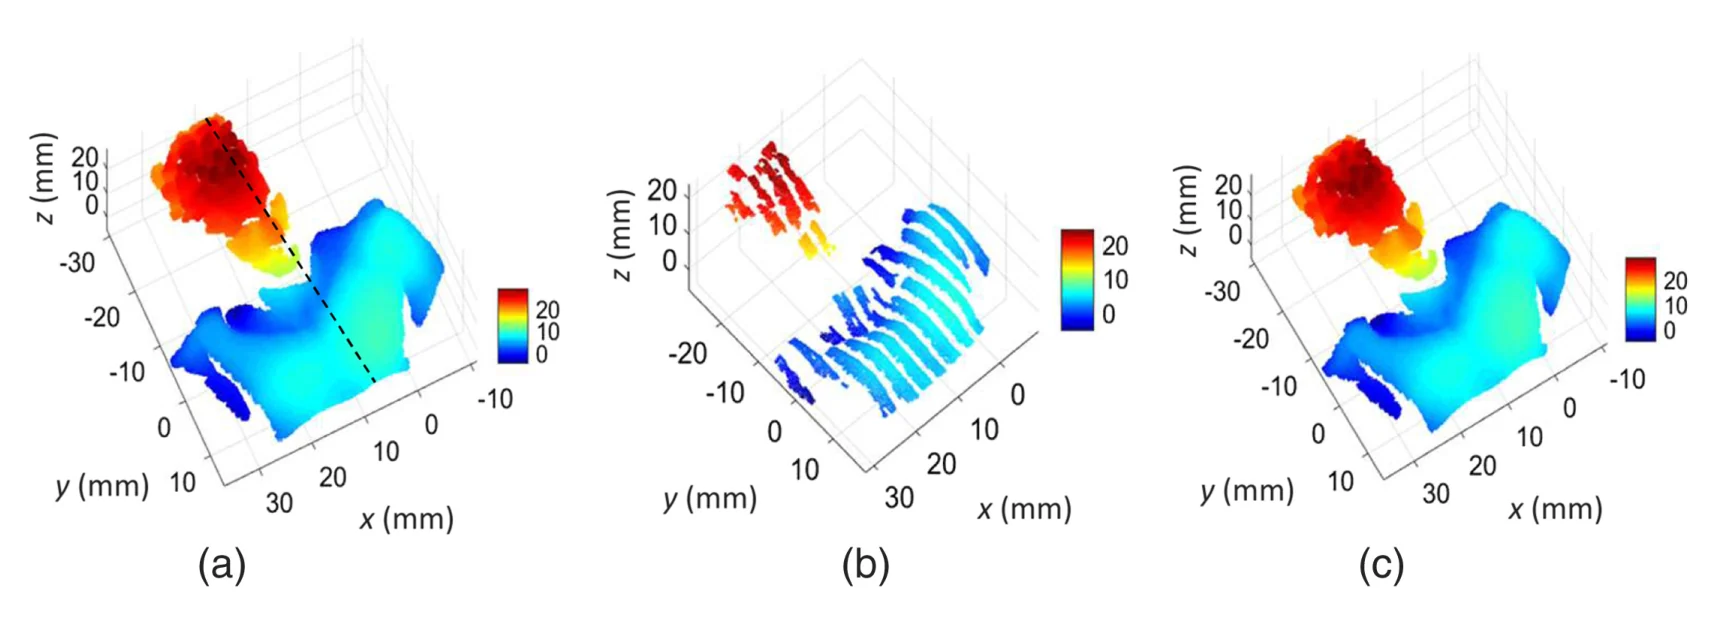
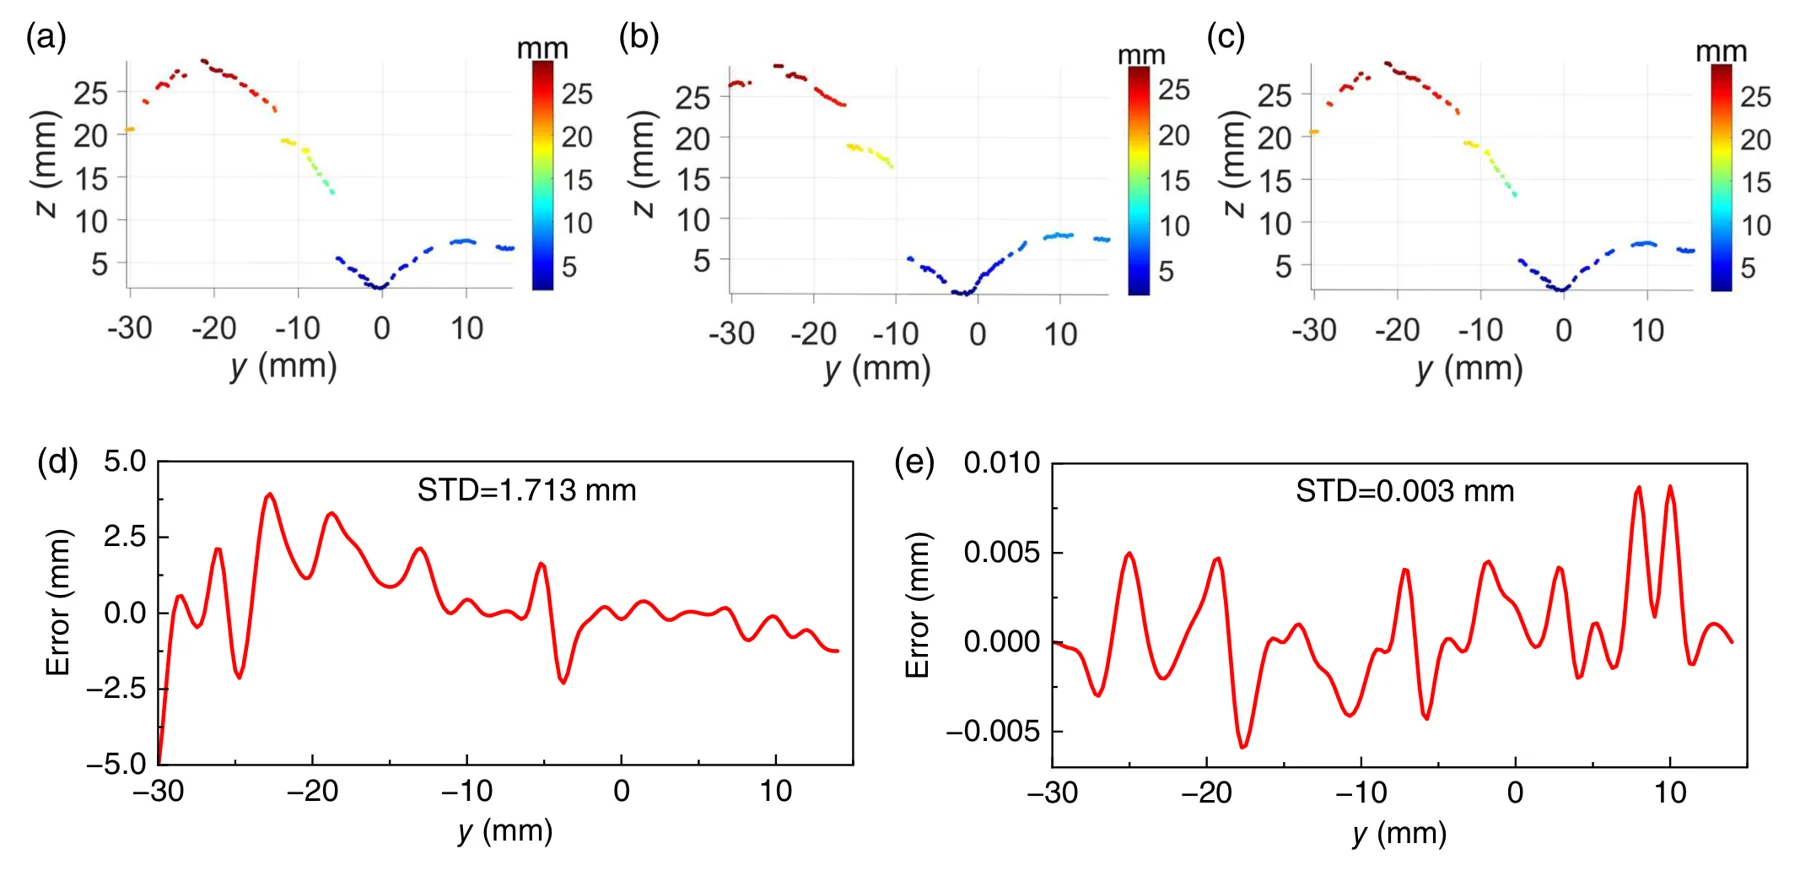
网络只用正弦条纹训练,却无需额外调整,也能分离投射到球体、汽车模型和一尊雕像上的二值混叠图案(图 14)。对于由螺旋桨样件、3D 打印螺栓和雕像组成、颜色和反射材质各不相同的多物体场景,该方法同样适用(图 15)。该方法假设每张图像只混入两幅图案。若投影速度远高于相机帧率,一次曝光内会混入两幅以上的图案;作者将这种更复杂的混叠列为方法的局限,也是后续研究的方向。
引用
@article{lu2024generative,
  title={Generative deep-learning-embedded asynchronous structured light for three-dimensional imaging},
  author={Lu, Lei and Bu, Chenhao and Su, Zhilong and Guan, Banglei and Yu, Qifeng and Pan, Wei and Zhang, Qinghui},
  journal={Advanced Photonics},
  volume={6},
  number={4},
  pages={046004--046004},
  year={2024},
  publisher={Society of Photo-Optical Instrumentation Engineers},
  doi={10.1117/1.ap.6.4.046004}
}