Deep transformer-enhanced dynamic structured light for three-dimensional moving object imaging
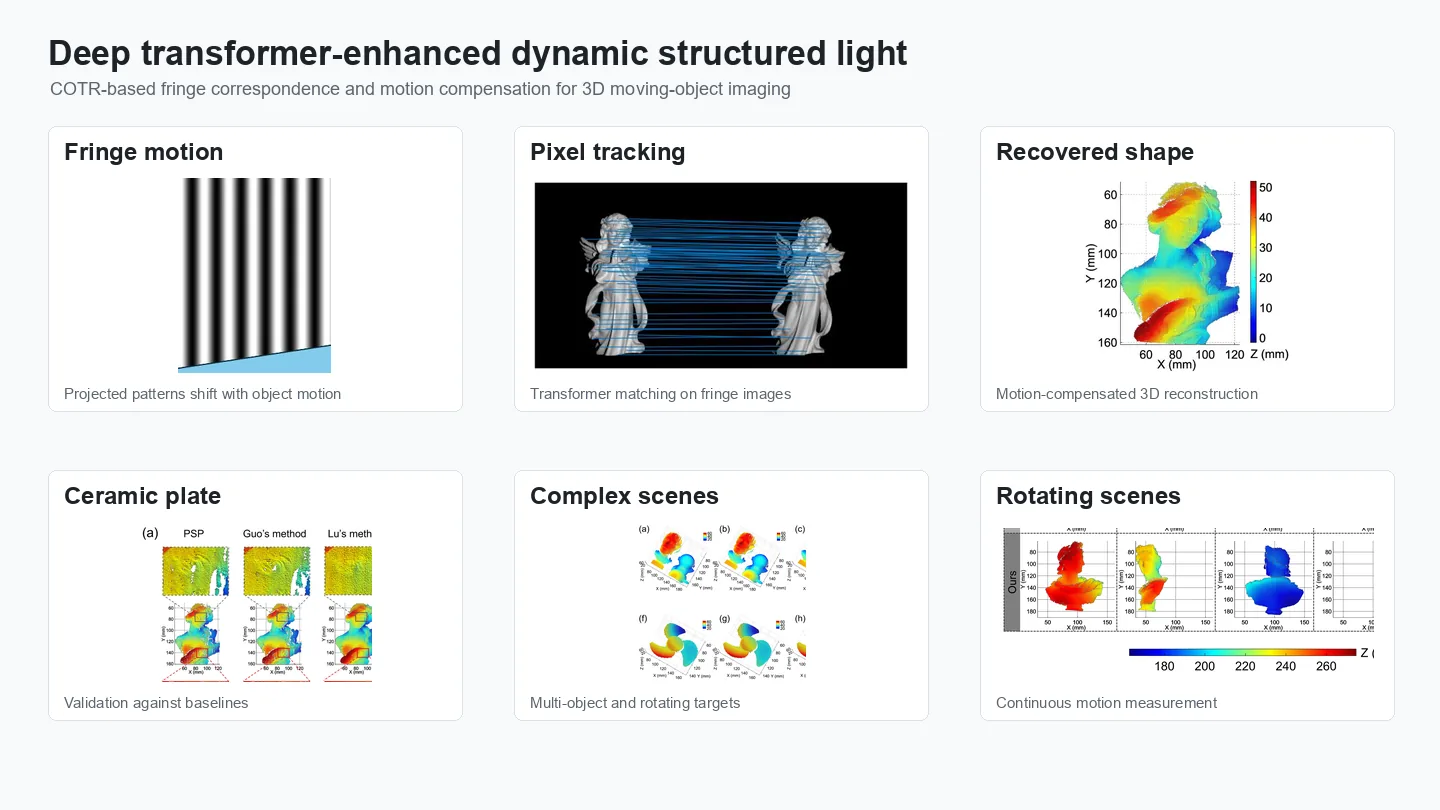
一句话看懂物体在相移结构光采集期间运动时,用 Transformer 跟踪各像素在条纹图像间的位置,再逐像素求解运动引起的相位误差,在运动平板上使 RMSE 从 1.401 mm(标准相移法)降至 0.072 mm。
问题背景
相移轮廓术(PSP)依次投射一组已知相移的正弦条纹,根据所采集图像的相位恢复物体表面的三维形貌。它对环境光和表面反射率的变化具有较强的鲁棒性,但至少需要三幅图像,并且在采集期间物体必须保持静止。物体一旦运动,同一表面点在各帧中会由不同的投影仪像素编码、被不同的相机像素观测,帧间的相移不再是预设值,从而产生波纹、相位展开错误,甚至导致重建失败。
提高投影和采集速度可以缓解这一问题,但会显著增加硬件成本,而且运动的影响依然存在。多数运动误差估计方法只处理深度方向的运动,无法解决其他方向运动造成的像素错位。Lu 等人的跟踪式补偿模型对 X–Y 平面内的运动效果较好,但对 Z 方向运动的处理能力有限;只估计整幅图像全局平移的方法,则难以捕捉像素级的局部运动差异。物体沿任意方向运动时,每个表面点都有各自的位移,因而也有各自的相位误差。
方法原理
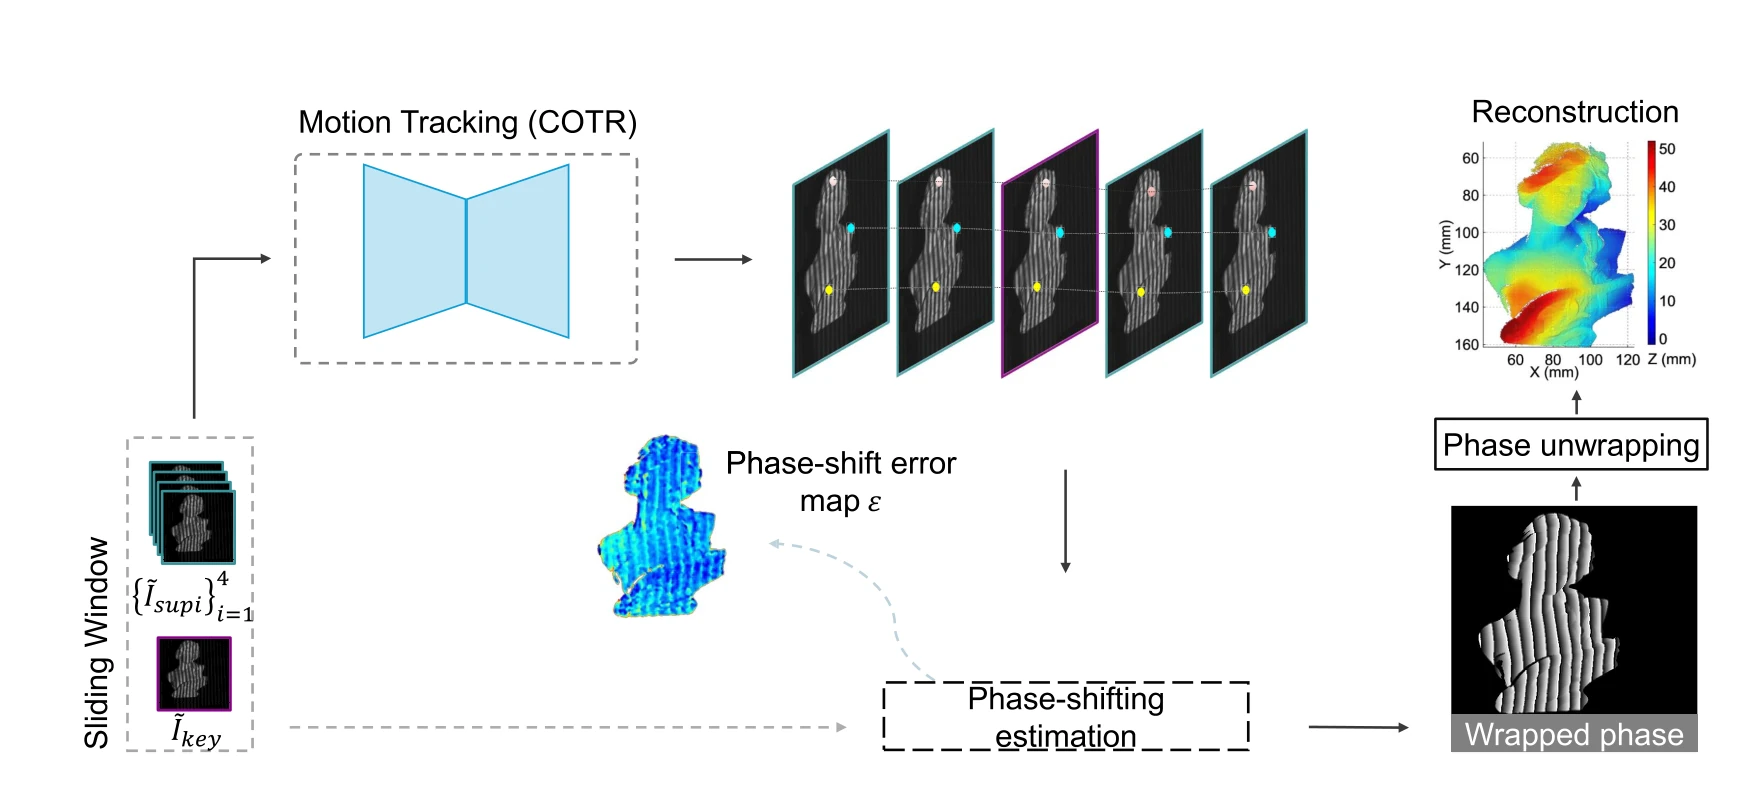
该方法保留标准的四步相移,并增加两个环节:一是基于学习的跟踪器,找出一幅条纹图像中的各像素在后续图像中的位置;二是对跟踪之后剩余相位误差的逐像素建模。两者都在长度为五帧的短滑动窗口内进行。
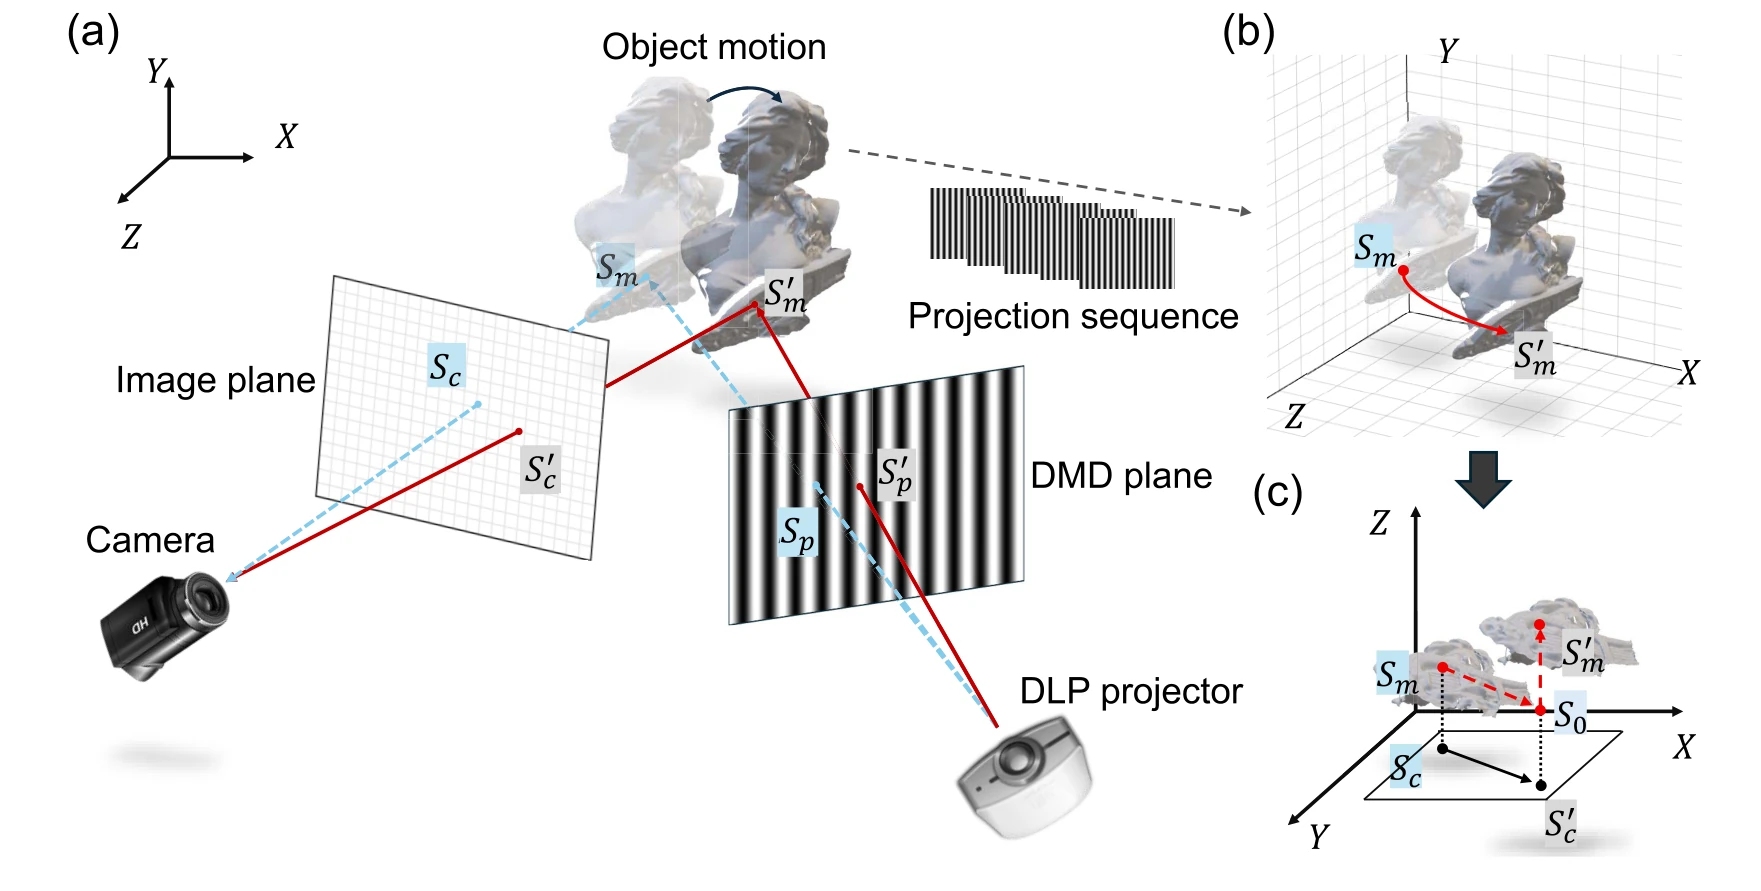
- 建立运动引起的相位误差模型。 投影仪循环投射四步相移条纹(相邻相移 π/2),相机同步采集运动物体的图像。每个表面点的运动被分解为两部分:面内位移使该点移到另一个像素 (Δu, Δv);沿 Z 方向的位移则引入额外的相位误差。总相位误差为两者之和。
- 用 Transformer 跟踪像素。 图像序列被划分为五帧一组的窗口,以中间帧为关键帧。COTR(COrrespondence TRansformer)网络以原始预训练权重初始化,并在条纹图像上微调,用于把关键帧中的查询像素匹配到窗口内其余四帧。共享权重的 CNN 骨干网络从两幅图像中提取特征,Transformer 编码器–解码器建立两者之间的关联,再由 MLP 头预测每个匹配点。
- 对齐各帧并求解 Z 向误差。 匹配结果给出逐像素的映射,据此对齐窗口内的五帧图像,使同一表面点在各帧间得到跟踪。在短时间窗口内,Z 方向速度近似不变,因此每经过一帧,相位就多出同样大小的误差 ε,窗口内第 n 帧(n = 1 至 5,关键帧为 n = 3)的 Z 向相位误差为 (n − 3)ε。综合五帧图像的光强可得到关于物体相位 Φ 与 ε 的三个方程;ε 较小时,它们化简为线性方程 K1ε + K0 = 0,在每个像素上求解后即可得到校正后的相位 Φ。
- 相位展开与三维重建。 校正后的包裹相位采用三频相移算法展开(两组低频条纹与高频条纹交替投射),再利用标定好的相机–投影仪模型转换为三维形貌。
- 滑动窗口。 窗口每次向后滑动一帧,每幅新采集的图像与其前四帧组成新窗口,即可重建出物体新的三维形貌。
实验结果
实验系统由一台分辨率 512 × 512、帧率 30 fps 的高速相机和一台 DLP 投影仪组成。为微调 COTR,作者将雕塑、玩具和工业零件置于装沙的浅盒(深约 5 cm)上,采集了 45 个动态场景、每个场景 60 种运动,共得到 2,700 对运动前后的条纹图像(2,400 对用于训练,300 对用于验证)。真值匹配的获取方式是:在每个位姿额外投射一幅空白图像,用鲁棒局部光流法在空白图像对上计算稠密位移场。训练约 1,400 个 epoch 后收敛,耗时约 42 小时。
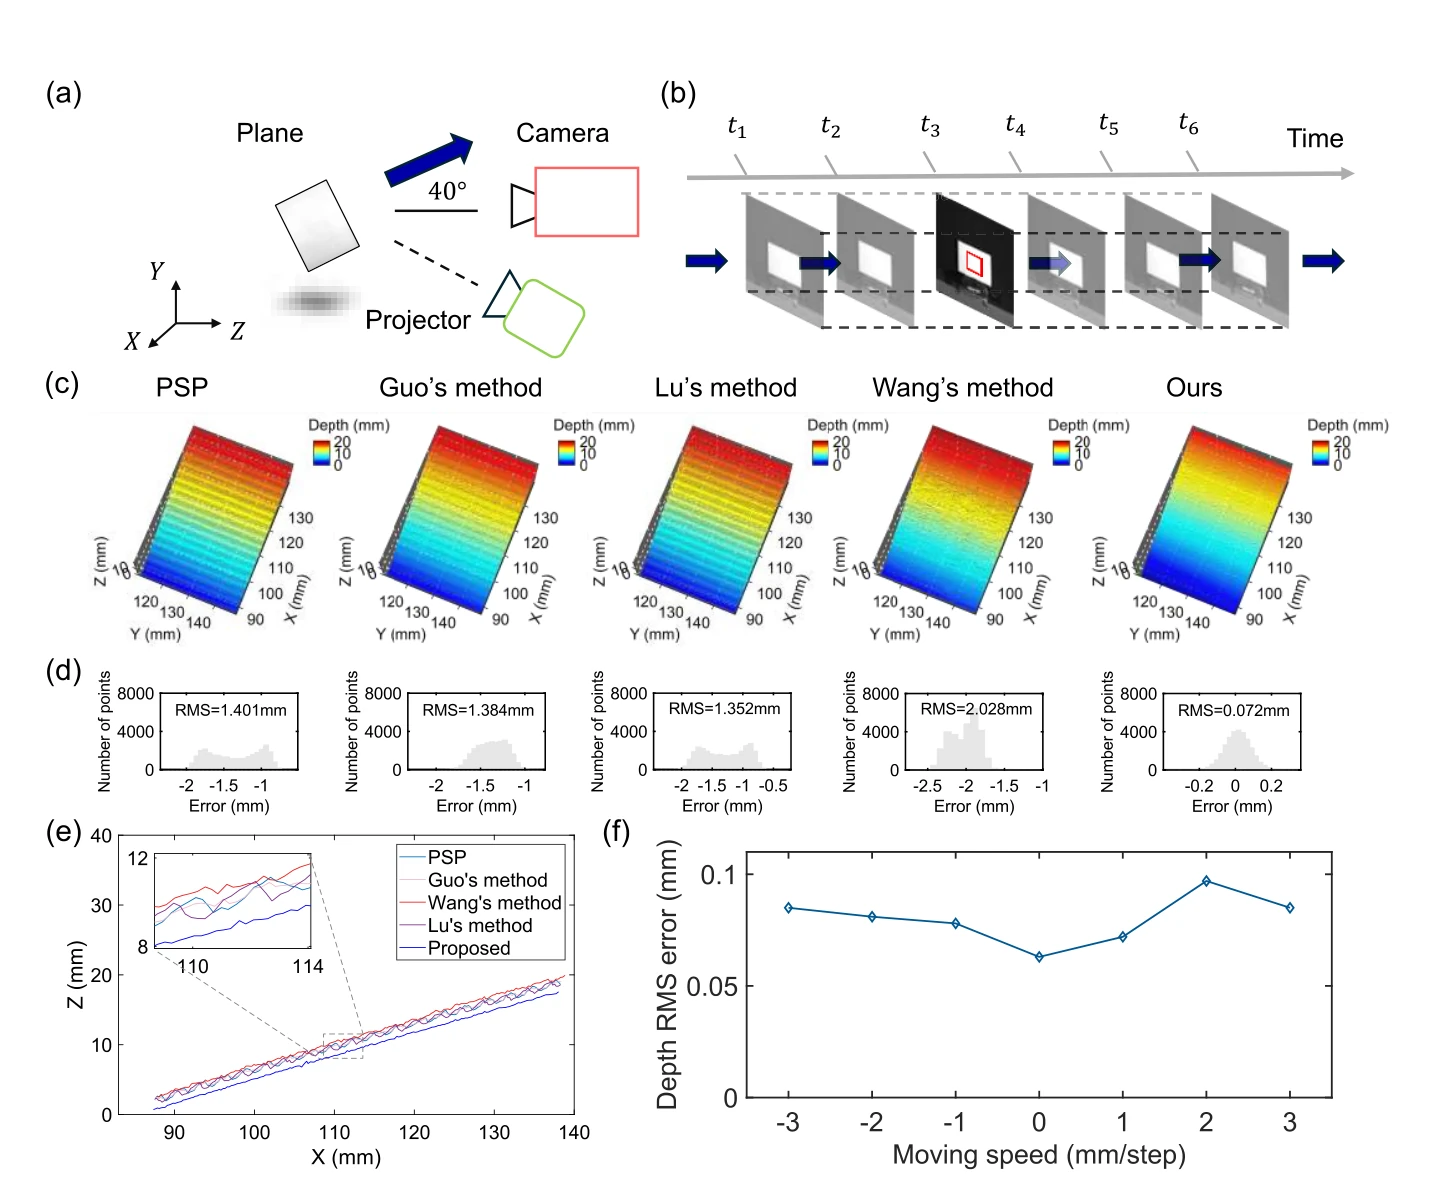
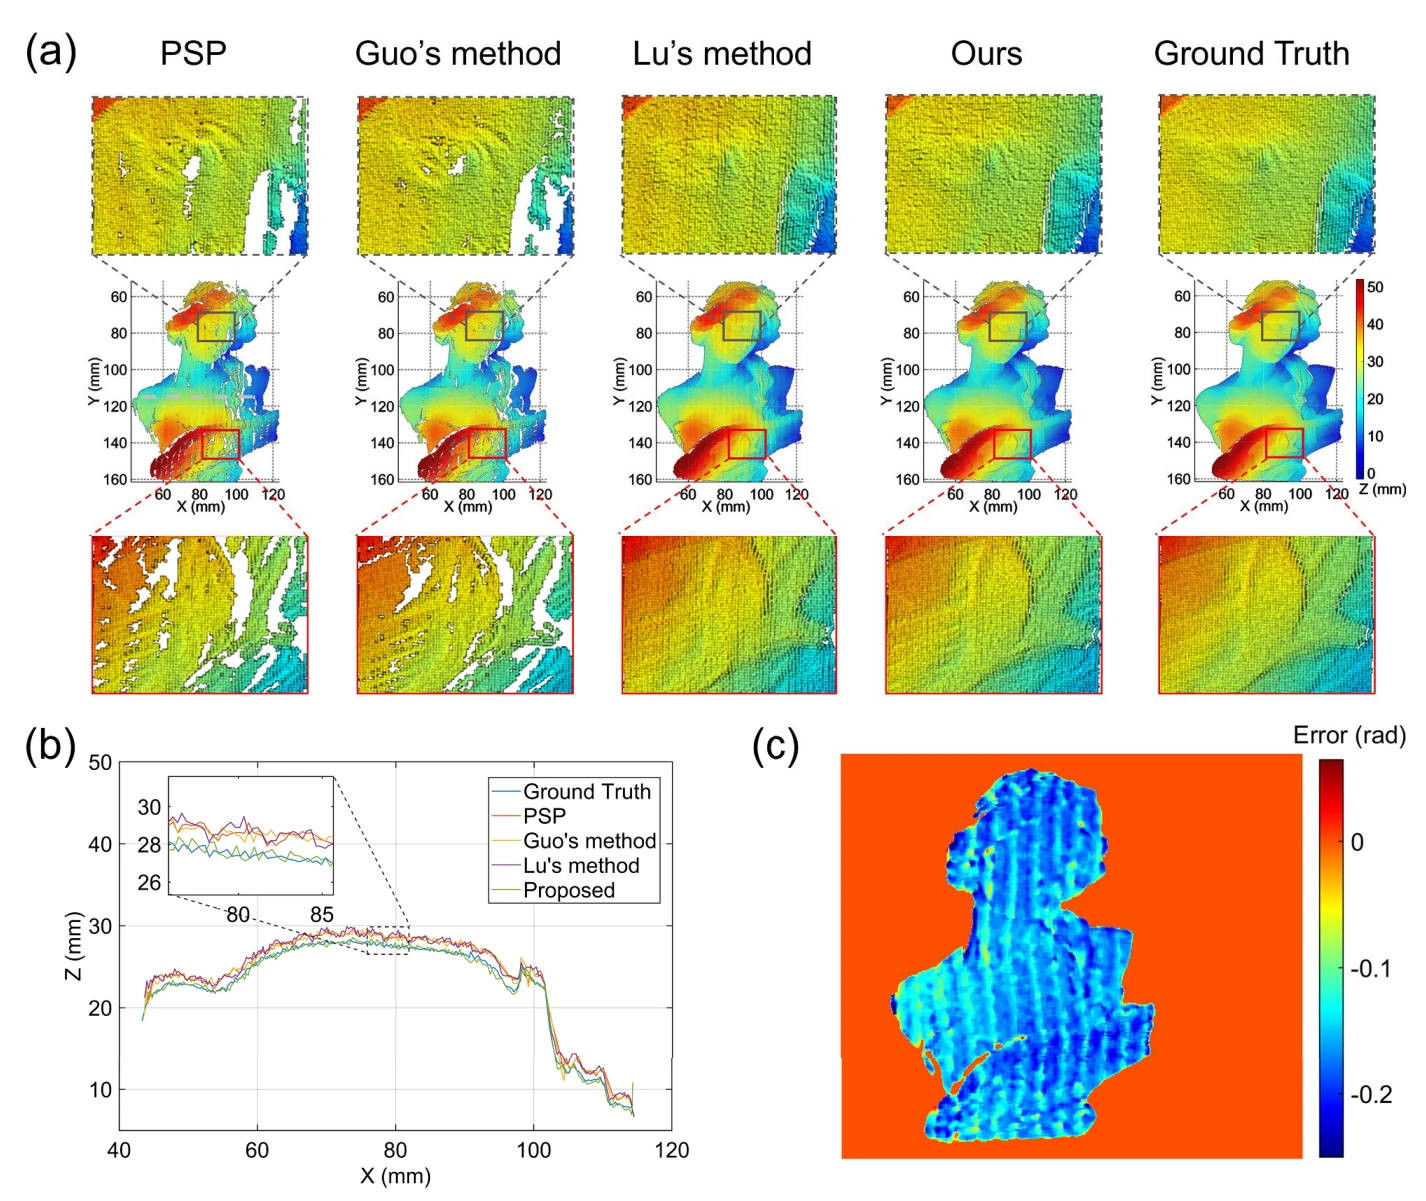
陶瓷平板由平移台带动,沿与相机光轴成 40° 的方向以 1 mm 步长运动,并以 12 步相移的测量结果作为真值。标准 PSP 的结果有明显的波纹畸变;Guo 的方法平滑了部分波纹;Lu 的方法只补偿 X–Y 平面内的运动;Wang 的方法简化了相移误差,误差反而更大。当步长取 ±1、±2、±3 mm 时,本文方法的 RMS 误差始终低于 0.1 mm(图 6(f))。在雕像实验中,PSP 出现条纹伪影,边缘处不连续;Guo 的方法在边缘区域仍有较大误差;Lu 的方法因未补偿 Z 向运动而残留周期性波纹;本文方法则更准确地恢复了轮廓。
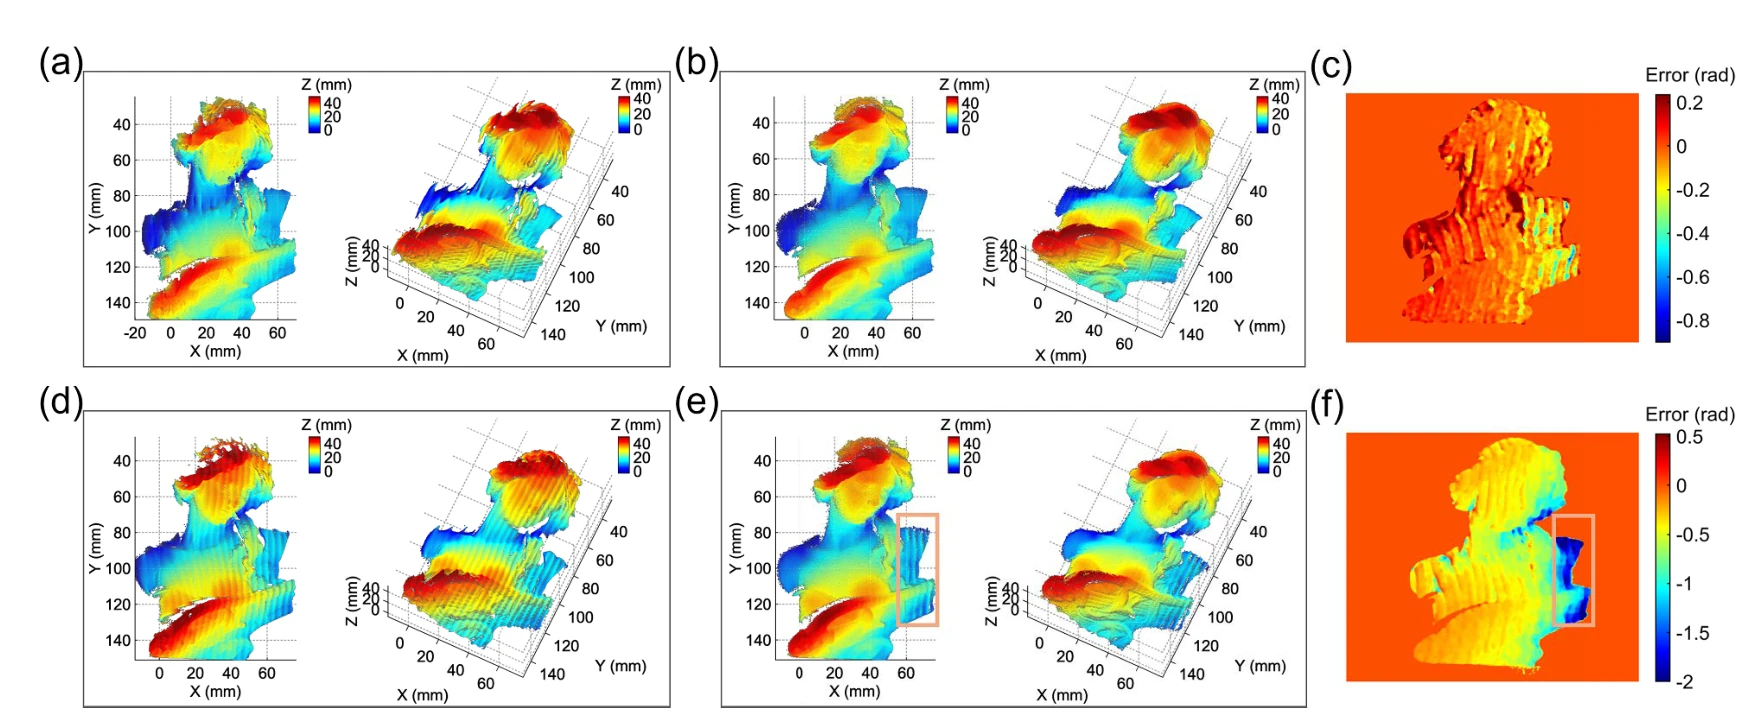
作者还在多种场景中测试了该方法:一尊静止雕像与一尊旋转雕像组成的多物体场景、表面光滑且纹理较弱的旋转风扇模型、置于连续旋转平台上的雕像,以及同时平移和旋转的物体。在平移与旋转复合运动下,旋转会在外侧区域引入高达约 1 rad 的相位偏差,而该方法仍能保持大部分表面区域的重建精度。作者也指出了局限:当 Z 方向平移过大时,相位误差估计仍可能失败(图 12 中的标记区域),作者建议提高投影速率,或将该框架与基于几何约束或格雷码的相位展开方法结合,以缓解这一问题。由于误差估计依赖五帧滑动窗口,该方法在帧间运动较小时才能可靠工作;常规帧率足以应对慢速到中速运动,快速运动的物体则需要高帧率相机和投影仪。
引用
@article{li2025deep,
  title={Deep transformer-enhanced dynamic structured light for three-dimensional moving object imaging},
  author={Li, Peng and Dou, Pengkai and Su, Zhilong and Lu, Lei and Pan, Wei},
  journal={Optics Express},
  volume={33},
  number={25},
  pages={52084--52104},
  year={2025},
  publisher={Optica Publishing Group},
  doi={10.1364/oe.579307}
}