DeSC: Learning Deep Semantic Descriptor for NeRF Registration
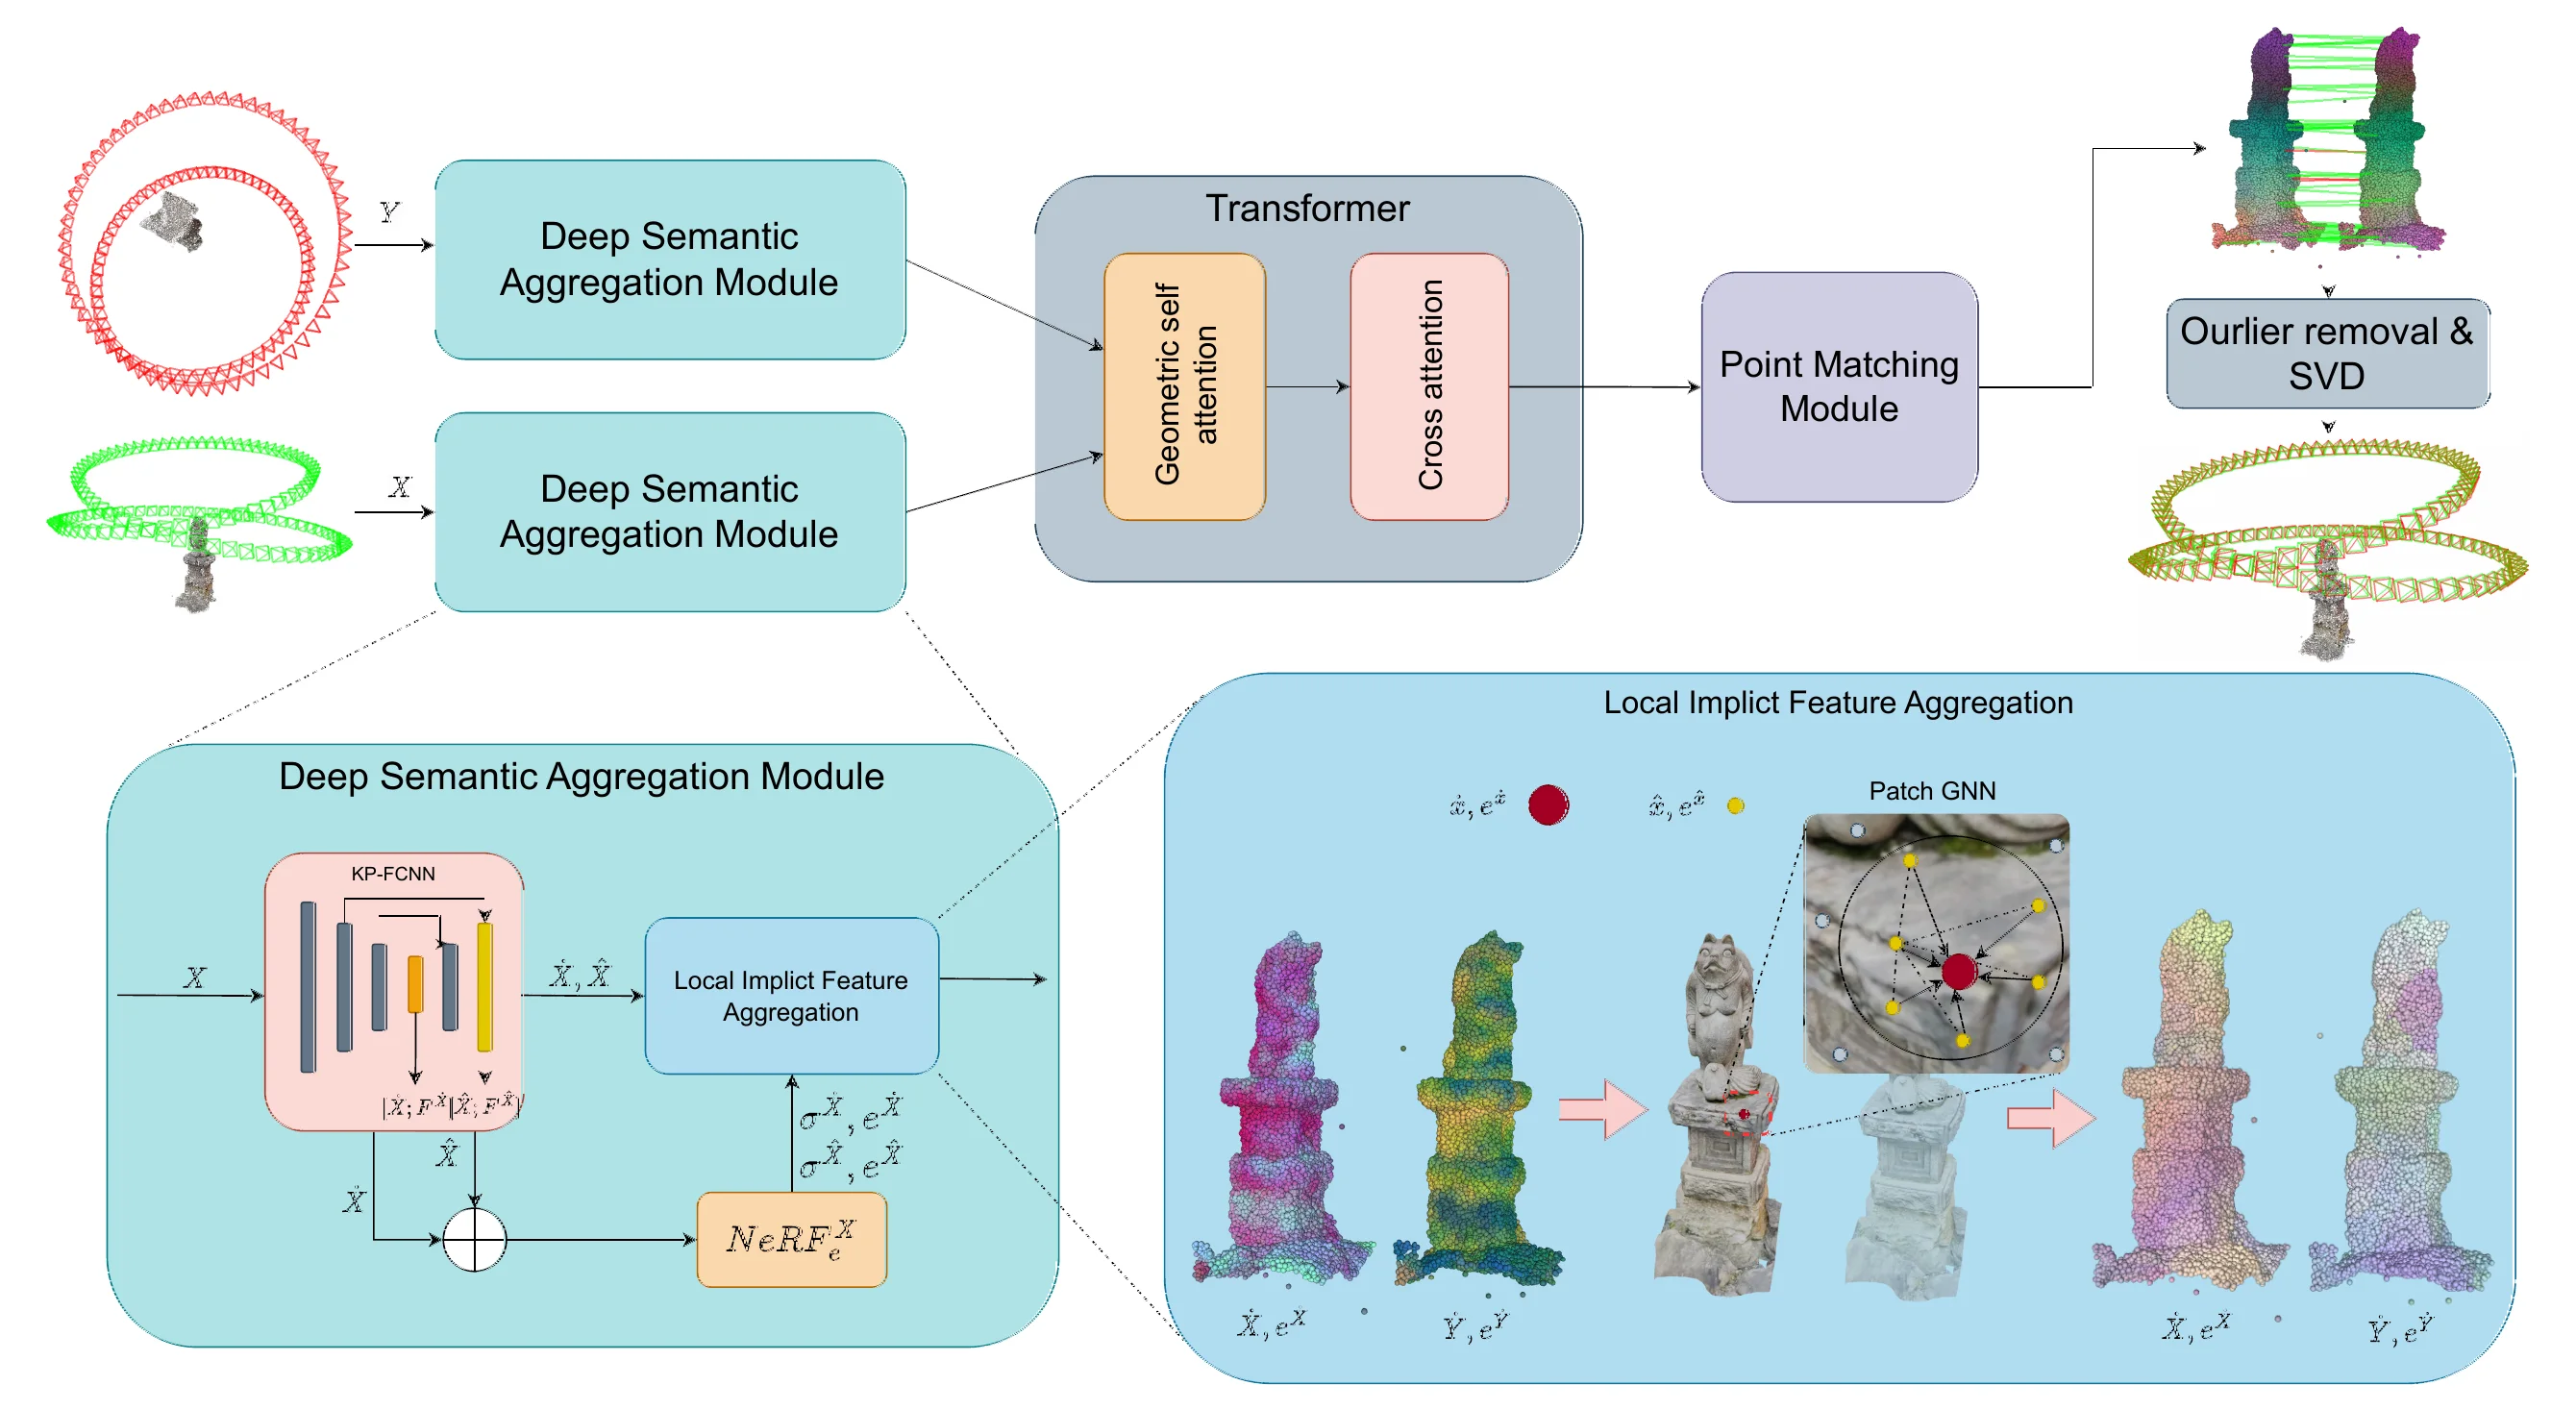
一句话看懂DeSC 从两个独立训练的 NeRF 自身的内部嵌入中学习描述子,而不只依赖采样得到的几何,在 Objaverse 上的配准召回率达到 97.7%,在 30% 重叠率的真实场景中依然稳健。
问题背景
神经辐射场(NeRF)把场景存储在神经网络之中。大场景常被拆分成多个 NeRF 分别训练;而在缺少可靠全局相机位姿的条件下采集的图像,训练出的各个 NeRF 也各自处于不同的坐标系中。要把它们合并起来,就需要估计两个独立训练的 NeRF 之间的刚体旋转和平移,即 NeRF 配准。
现有方法要么依赖几何信息,要么依赖渲染颜色。DReg-NeRF 从每个 NeRF 中采样点云并直接回归对应关系,但由于体密度估计不准确,尤其在 NeRF 训练不充分时,这些点云噪声大、伪影多。VF-NeRF 借助光度损失进行优化,因而在无纹理和高度对称的情形下容易失效。两者都没有利用 NeRF 内部为每个三维点计算的、与视角无关的嵌入特征,而这种嵌入同时包含几何与外观信息。不过,直接使用它也并不容易:两个 NeRF 分别训练,嵌入空间并不一致。
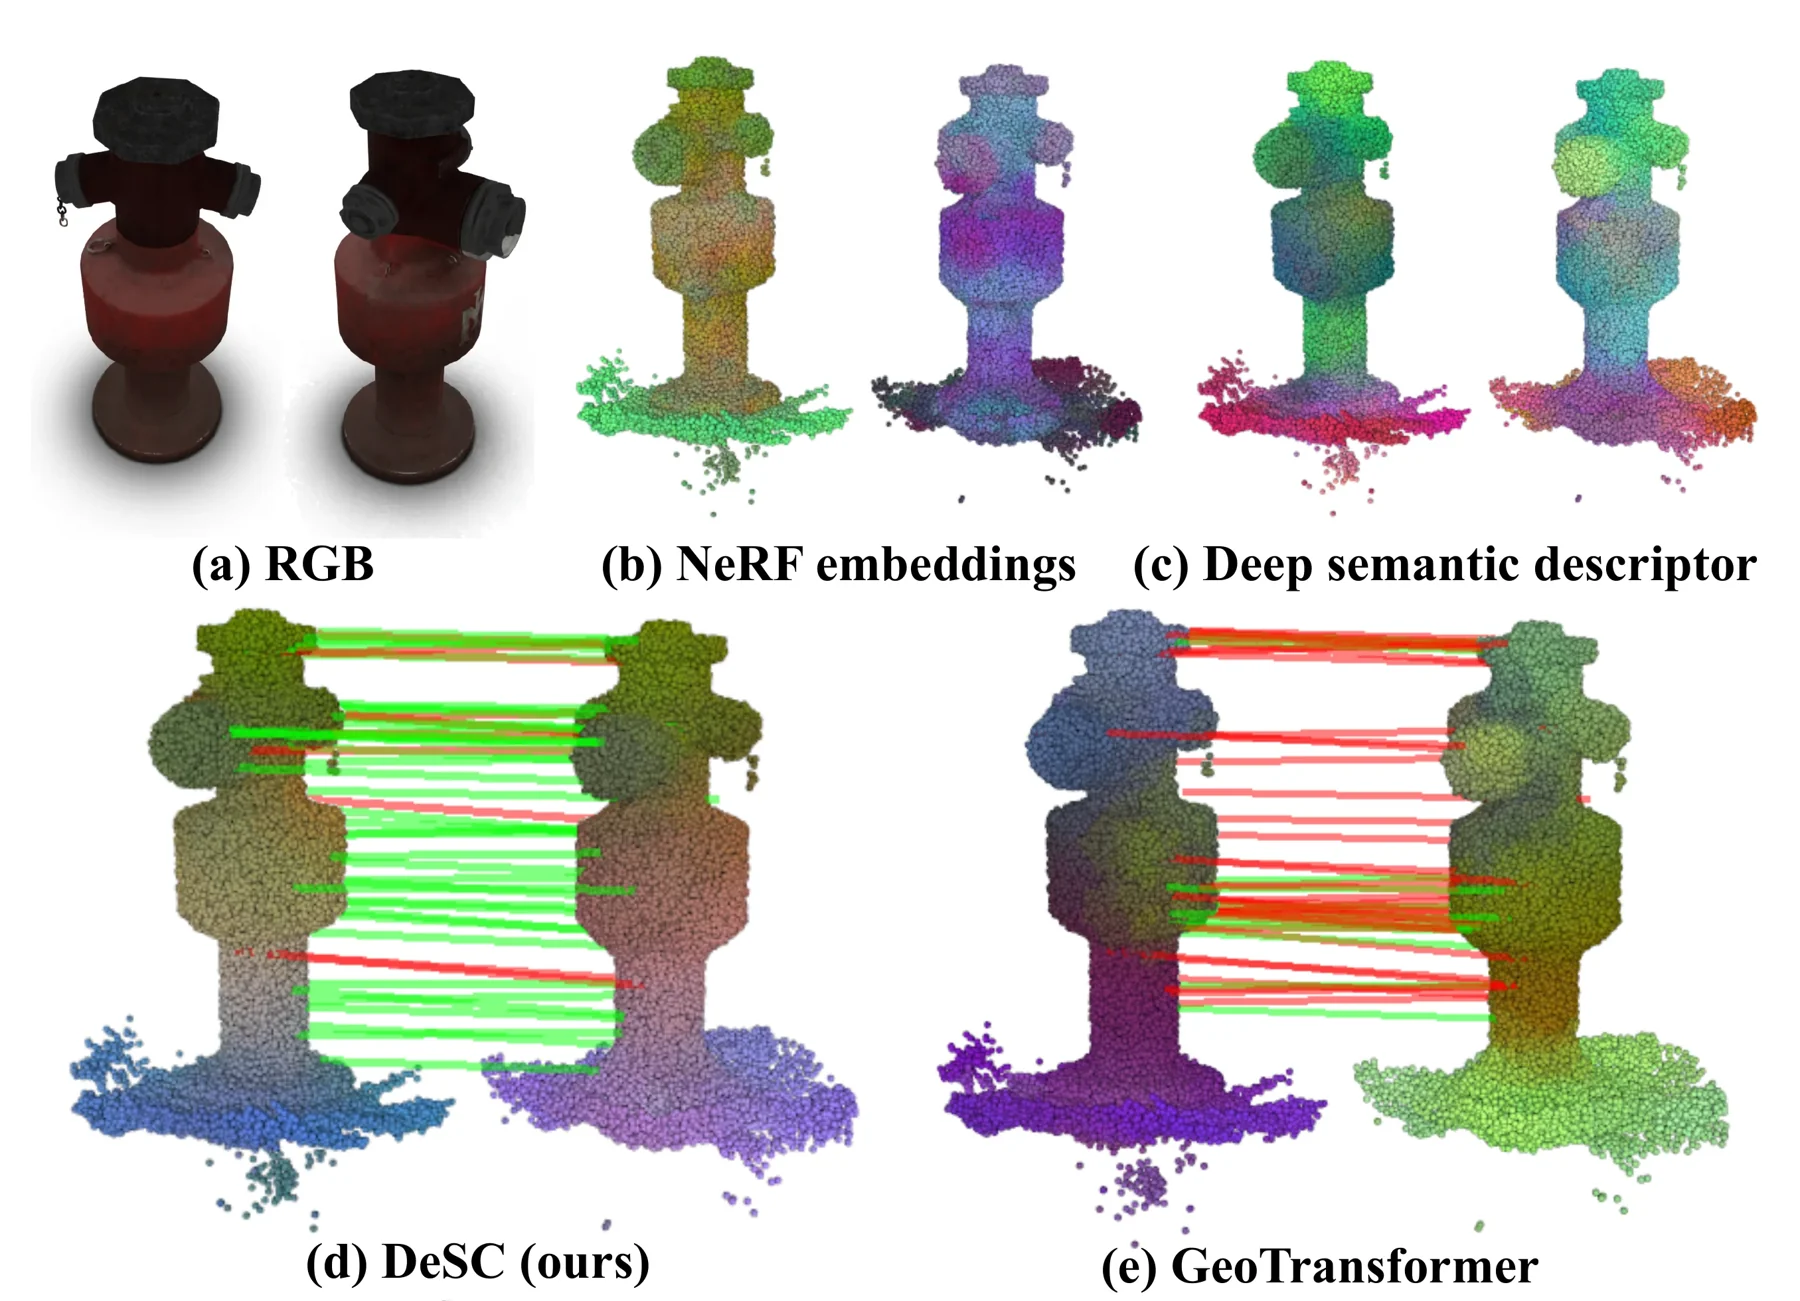
方法原理
DeSC 不仅把 NeRF 视为几何来源,也把它当作点特征的来源。它从每个 NeRF 中采样点云,用 KPConv 骨干网络提取几何特征,并通过深度语义聚合模块(DSAM)把 NeRF 自身的嵌入转化为在两个 NeRF 之间一致的描述子。随后由 Transformer 和粗到精匹配建立对应关系,最终用 SVD 求解位姿。
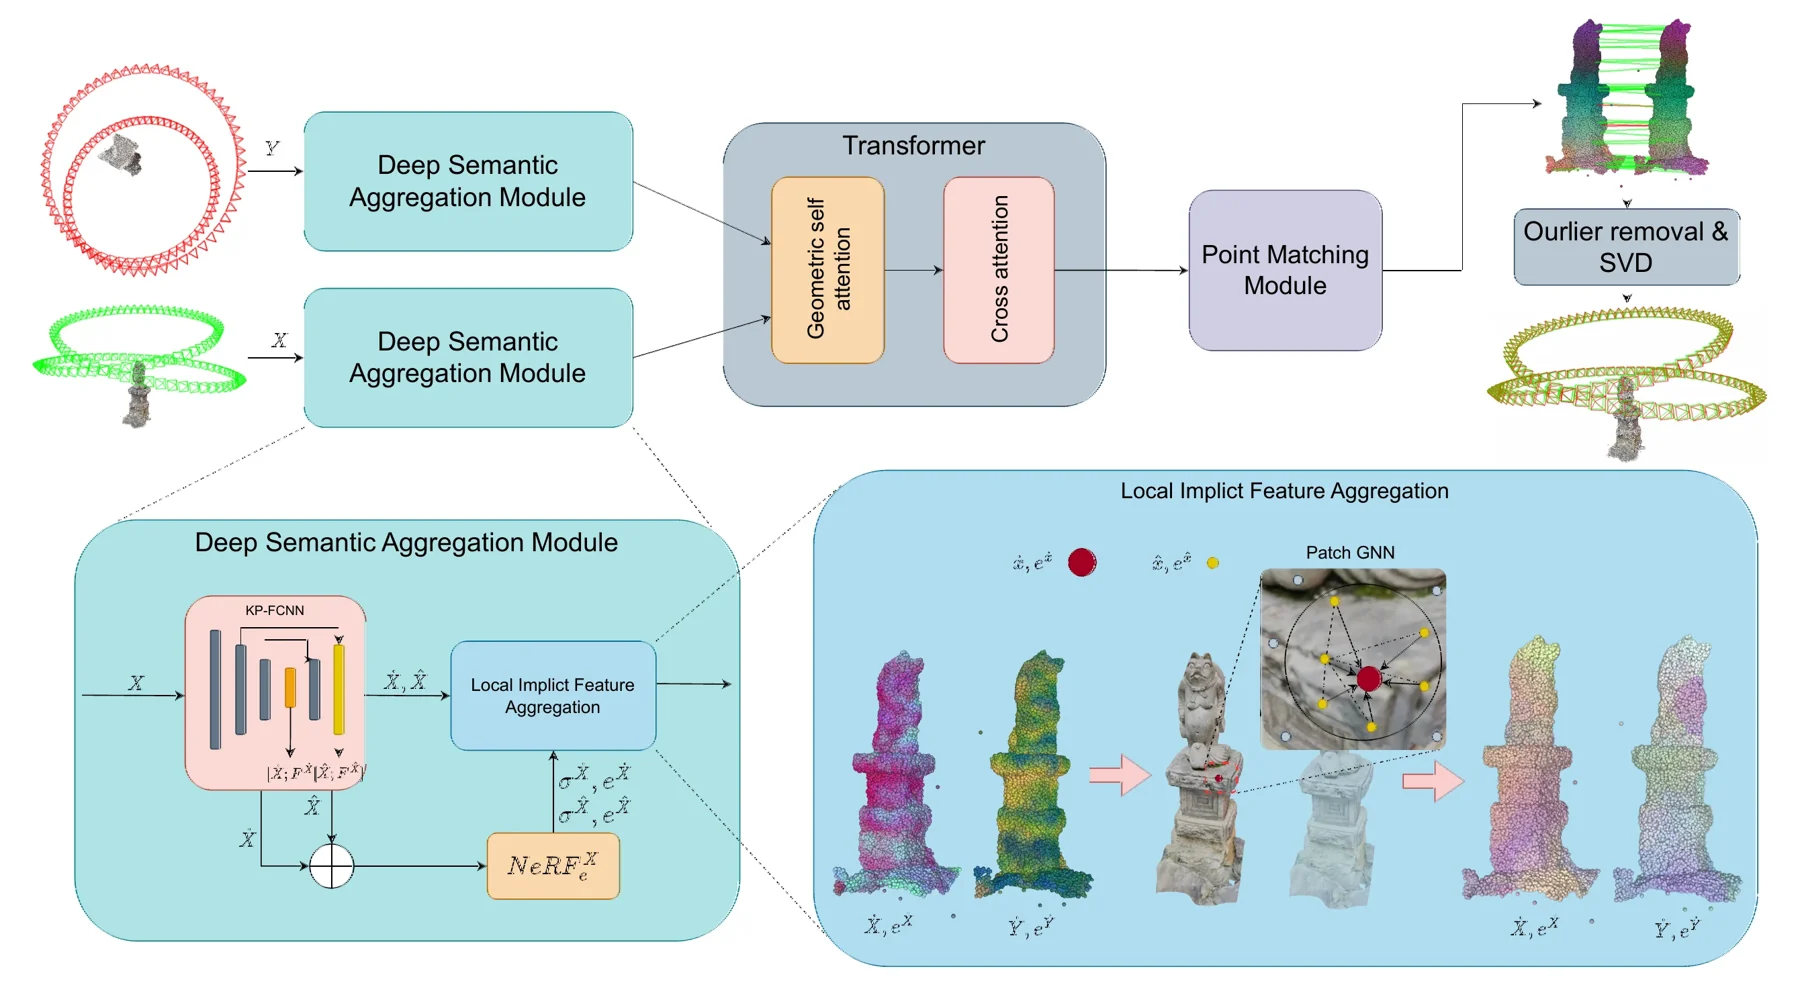
- 对每个 NeRF 采样。 DeSC 取 NeRF 占据栅格中非空体素的中心点,保留密度大于阈值 σt 的点。KP-FCNN 对该点云做分层下采样,同时提取多层级几何特征。
- 在稀疏点周围查询嵌入。 对每个稀疏点(最粗一级下采样中的点),取半径 τ 内、相邻较稠密一级中最近的 k 个稠密点组成局部块。块内每个点向 NeRF 查询与视角无关的嵌入,并通过正弦编码融入该点的颜色和密度,使特征带上两个 NeRF 共有的光度信息。
- 用纹理感知图卷积聚合。 在每个局部块上运行图卷积,其边权突出距离近而特征差异大的点对,从而捕捉局部高频纹理。输出再与几何特征融合,得到深度语义描述子。
- 引入上下文并匹配。 几何自注意力和交叉注意力让每个点云从自身和另一个点云中获取上下文信息。基于得到的特征选出粗对应关系,再在稠密点上用最优传输层细化。
- 求解位姿。 剔除外点后,用 SVD 求出对齐两个 NeRF 的旋转和平移。训练时,密度感知光度一致性损失还要求匹配的局部块具有相近的密度加权颜色。
实验结果
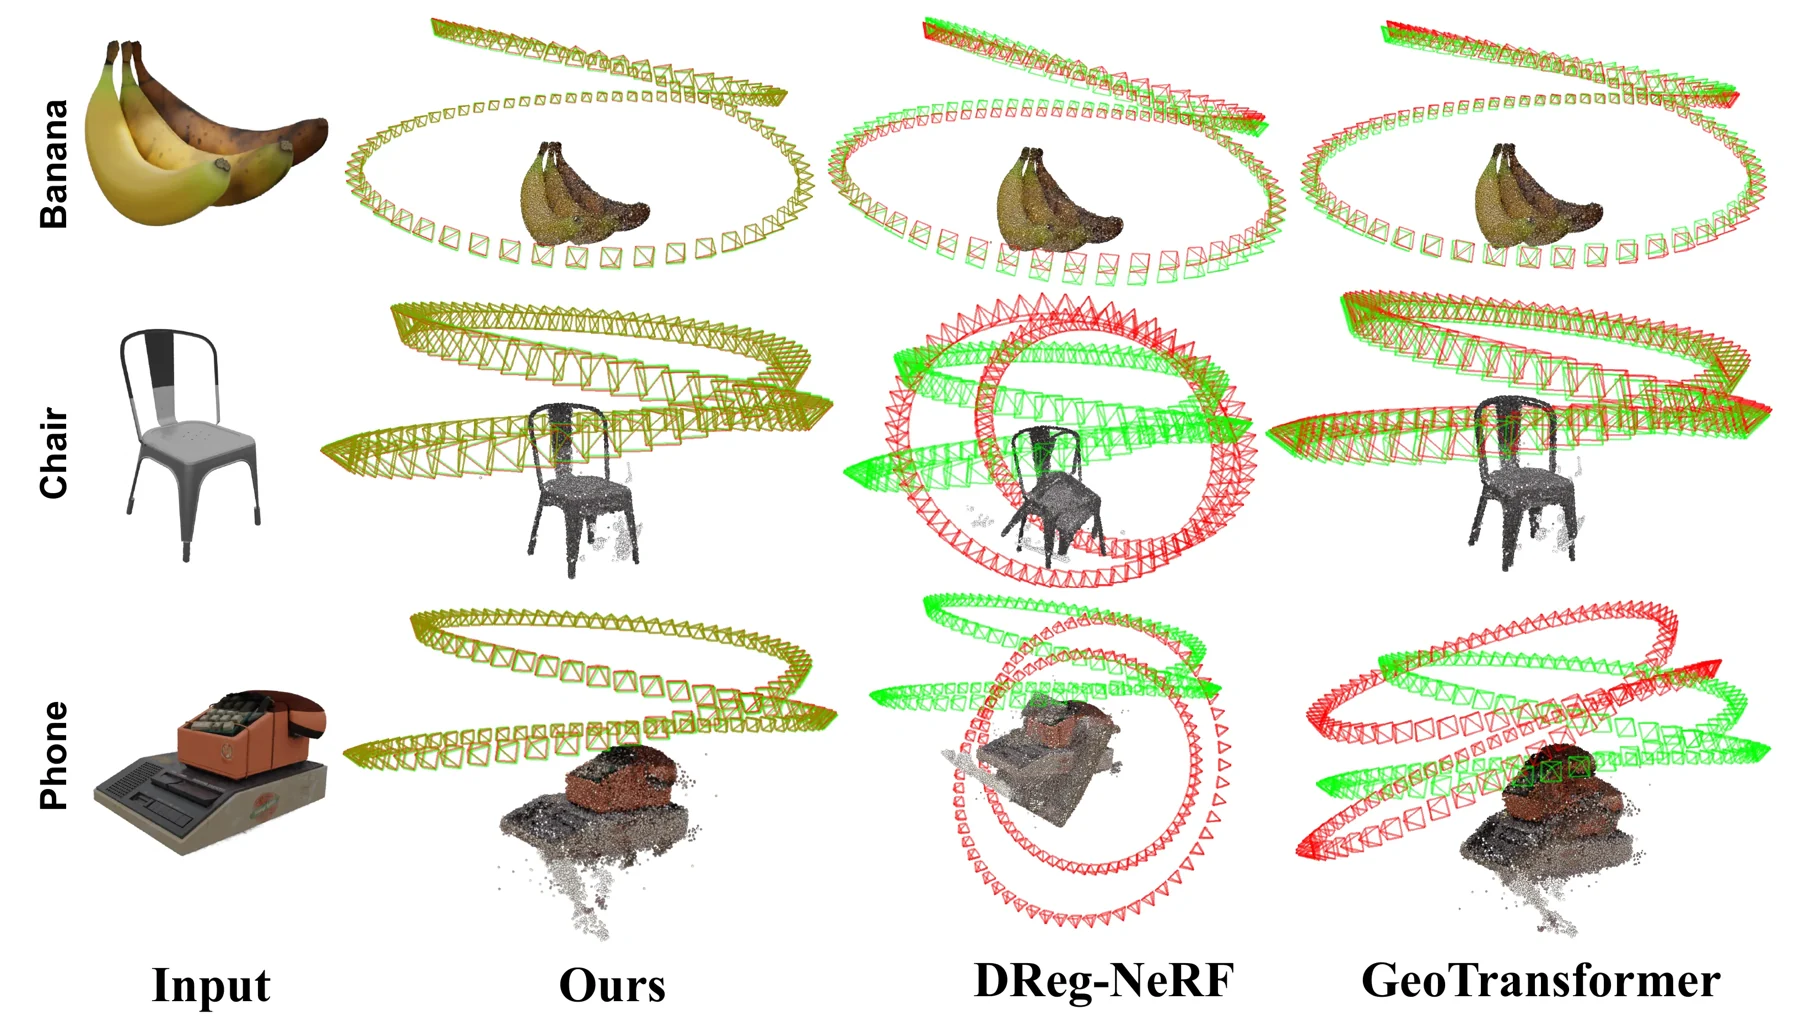
物体级基准基于 Objaverse 构建:每个物体渲染 120 张图像并分成两组,每组施加一个随机变换,再分别训练独立的 NeRF;测试使用训练中未见过的 44 个物体。配准召回率统计估计变换的 RMSE 小于 0.2 m 的样本对所占比例。对比方法包括 NeRF 配准方法 DReg-NeRF 和 VF-NeRF,以及八种在 NeRF 采样点上运行的点云配准方法。加入幅度为场景尺寸 10% 的均匀噪声后,DeSC 的召回率仍为 95.74%(表 II)。
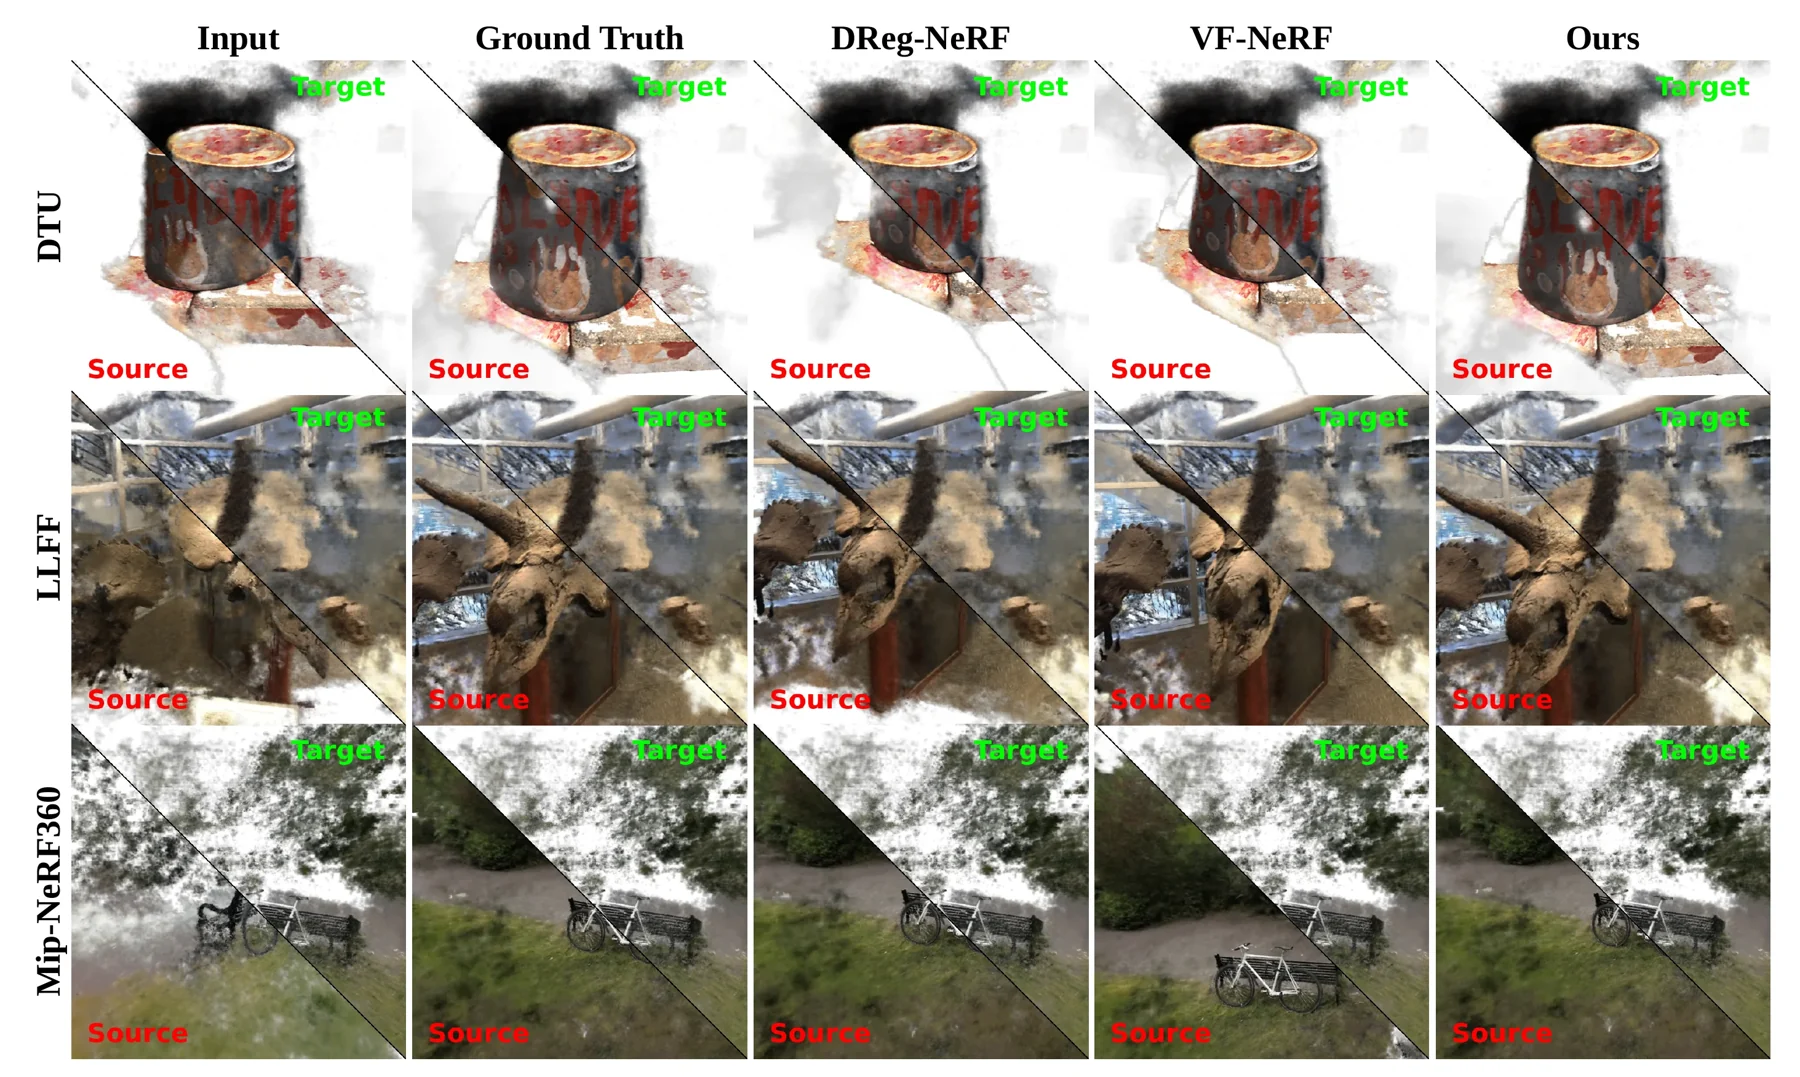
在真实场景数据集 DTU、LLFF 和 Mip-NeRF360 上,每个场景被划分为重叠率 30%、50% 和 80% 的图像子集。DeSC 在全部九种设置下的配准召回率均为最高,且在 30% 重叠率时优势最大;不过在部分设置下,VF-NeRF 的旋转误差略低。消融实验中,依次加入深度语义聚合、光度编码、纹理感知边权和光度一致性损失,Objaverse 上的召回率逐步提升:未加入任何模块时为 93.2%,随后依次为 93.9%、95.1%、96.9% 和 97.7%。
作者指出了两点局限。DeSC 依赖 NeRF 的隐式嵌入,因此不能直接用于 3D Gaussian Splatting、体素网格或基于哈希的方法等显式表示。对于形状和纹理都高度对称的物体(例如交通锥),提取的特征同样呈对称分布,可能导致错误匹配,即便渲染出的对齐结果看起来合理。
引用
@article{fung2025desc,
  title={DeSC: Learning Deep Semantic Descriptor for NeRF Registration},
  author={Fung, Sheldon and Pan, Wei and Su, Kui and Cui, Hui and Zhao, Xinkui and Lu, Xuequan},
  journal={IEEE Transactions on Visualization and Computer Graphics},
  year={2025},
  publisher={IEEE},
  doi={10.1109/tvcg.2025.3596289}
}