SemReg: Semantics-Constrained Point Cloud Registration
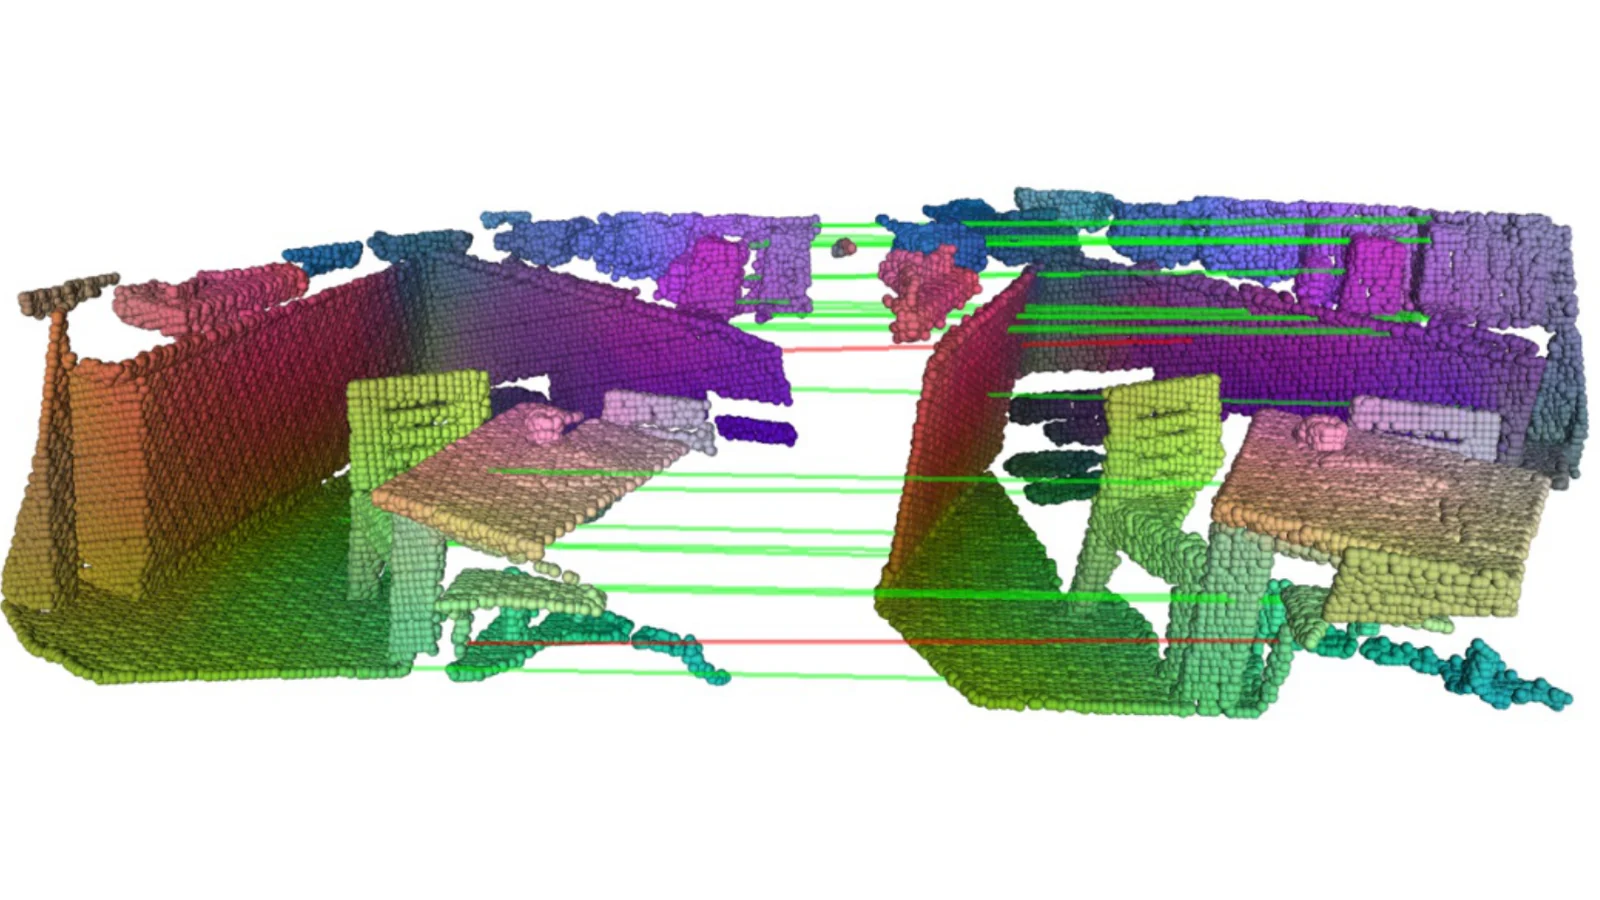
一句话看懂SemReg 从彩色图像中读取语义,只在语义相近的区域之间匹配点:椅子对椅子、桌子对桌子,从而更可靠地配准两帧 RGB-D 扫描,在 3DMatch 上的配准召回率(估计变换误差小于 0.2 m 的扫描对所占比例)达到 94.7%。
问题背景
点云配准的任务,是求出一组旋转和平移,把同一场景、部分重叠的两帧三维扫描对齐,进而拼接成完整的模型。近年的学习方法通常先用每个点周围的局部形状来描述该点,再通过交叉注意力让两帧点云交换信息,最后进行点匹配。然而,仅凭几何形状往往存在歧义:床和桌子的局部扫描在几何上可能十分相似。此外,交叉注意力会让一帧中的每个区域与另一帧中的所有区域发生交互,其中包括不太可能重叠的区域对,例如一帧里的椅子和另一帧里的桌子。这些冗余交互会导致错误匹配。
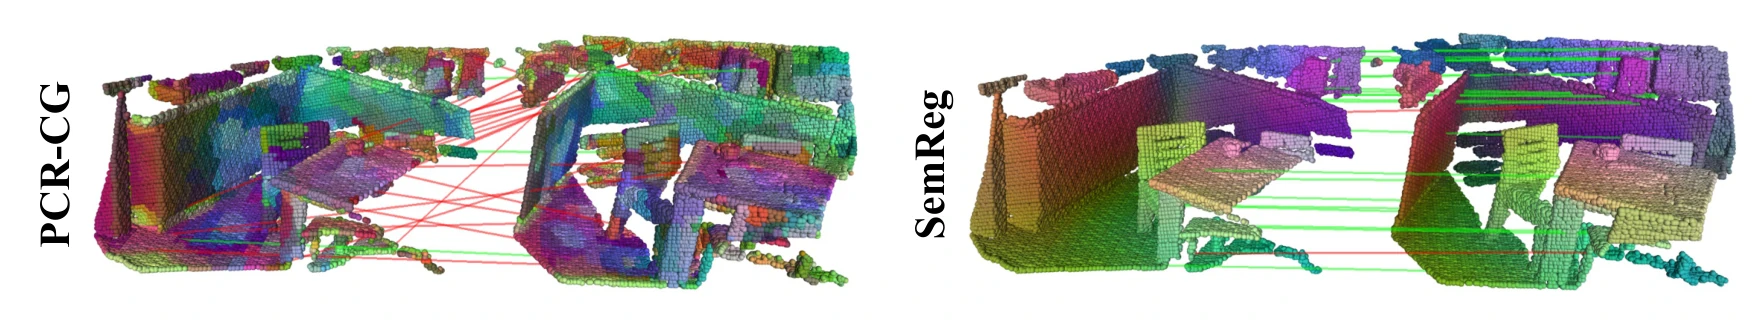
用 RGB-D 相机采集的室内扫描本身附带彩色图像,而二维图像上的语义理解远比三维几何上成熟。此前的跨模态方法 PCR-CG 已将图像颜色引入三维特征,但它只用到了颜色,并未利用图像中的语义信息,得到的特征仍不够一致。
方法原理
SemReg 是一个二维–三维跨模态网络。它保留常规的三维骨干网络来提取形状特征,同时从 RGB 图像中引入语义信息,并在三个环节加以利用:注意力计算、匹配阶段和训练损失。
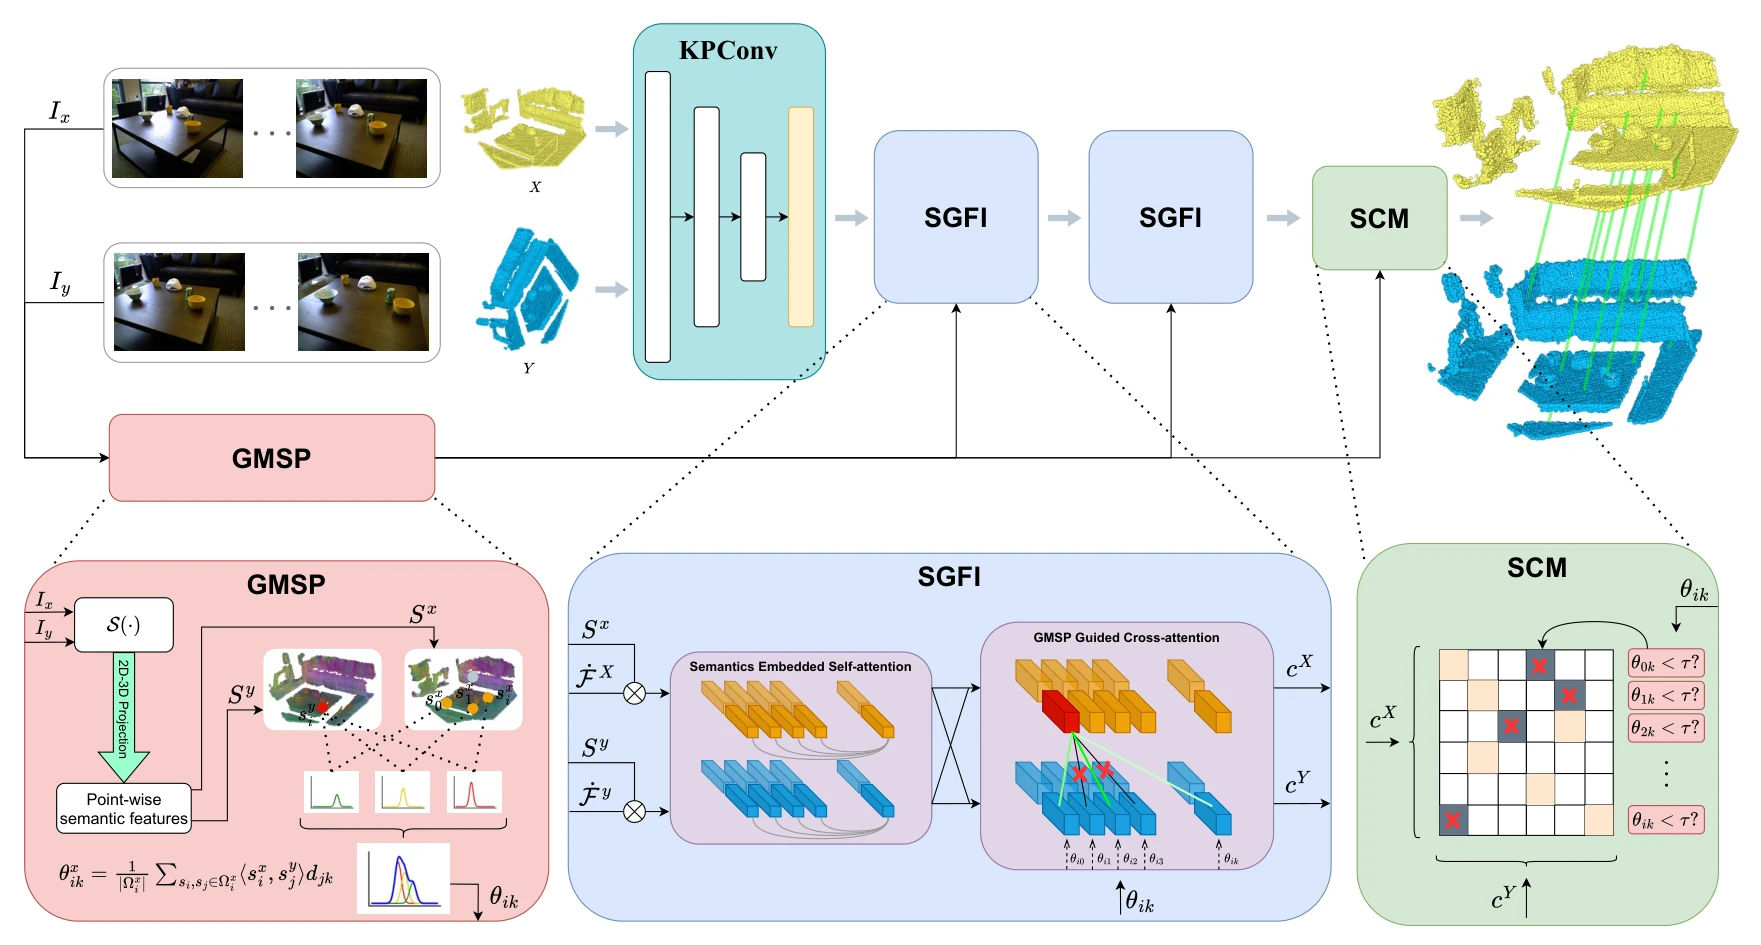
- 两帧扫描及其彩色图像。 输入是一对部分重叠的点云,各自带有对应的 RGB 图像。KPConv 骨干网络对每帧点云下采样,并提取局部形状特征。
- 从图像中提取语义特征。 参数冻结的预训练 DINOv2 网络从 RGB 图像中提取特征;借助深度和相机参数,这些特征被投影到三维点上,并在自注意力中与形状特征融合。
- 语义先验引导交叉注意力。 对源点云中的每个点,SemReg 找出目标点云中语义特征与之相近的点,并以这些点为中心、按三维欧氏距离构造高斯分布。这些高斯分布的混合即高斯混合语义先验(GMSP),用来对交叉注意力加权,使特征交互主要发生在语义相近的区域之间。
- 在语义相近的区域内匹配。 语义约束匹配模块在语义先验表明两点分属无关区域时,将该候选点对的匹配分数置零。训练时,语义感知焦点损失只对语义相关的点对进行监督。
- 由保留的匹配求解位姿。 最终的旋转和平移由 RANSAC 从对应关系中估计,并可进一步用 ICP 精化。
实验结果
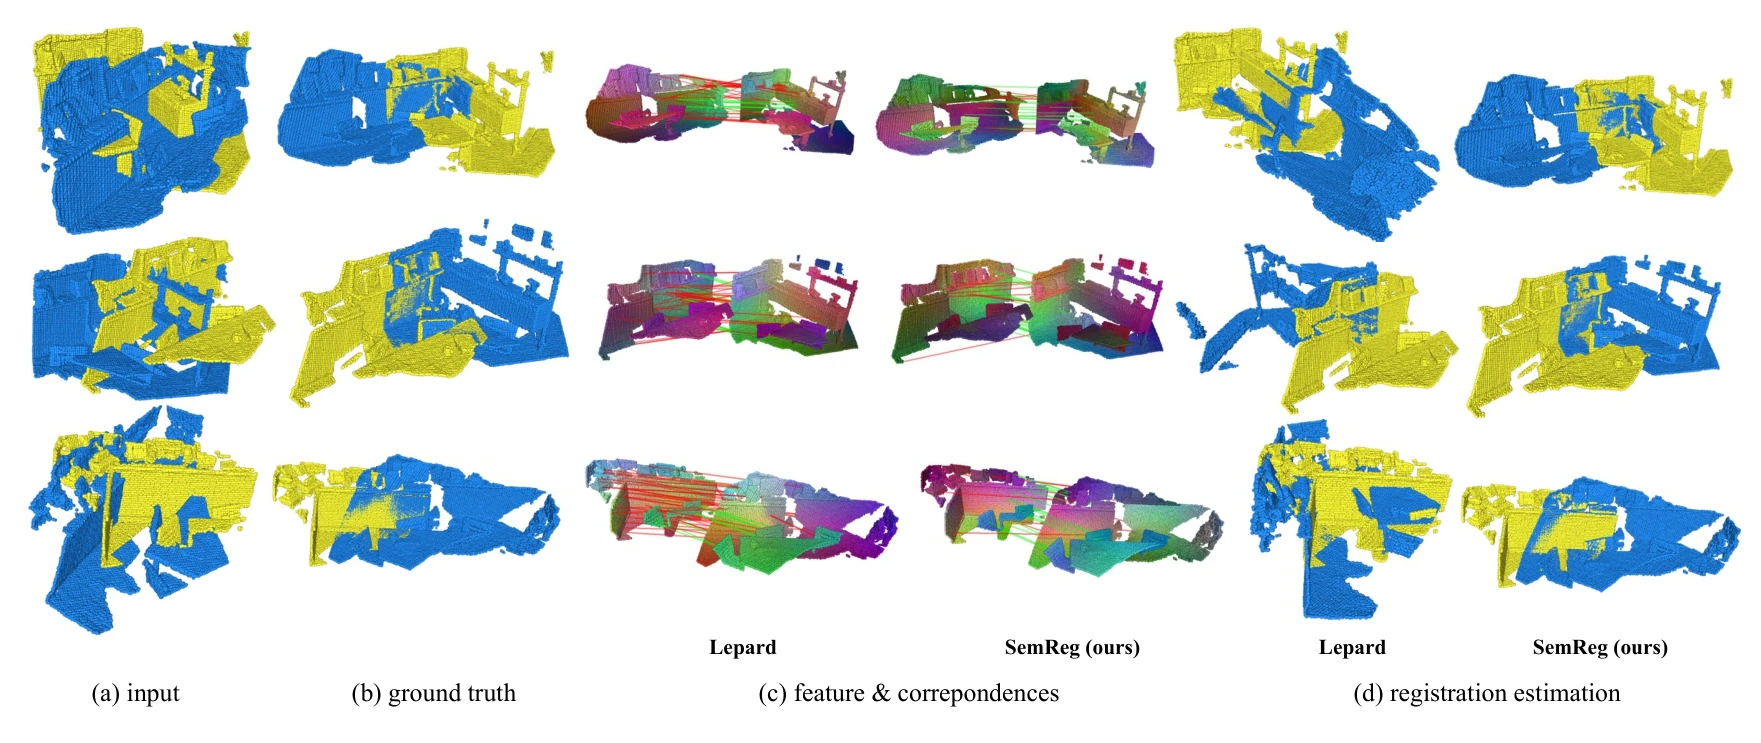
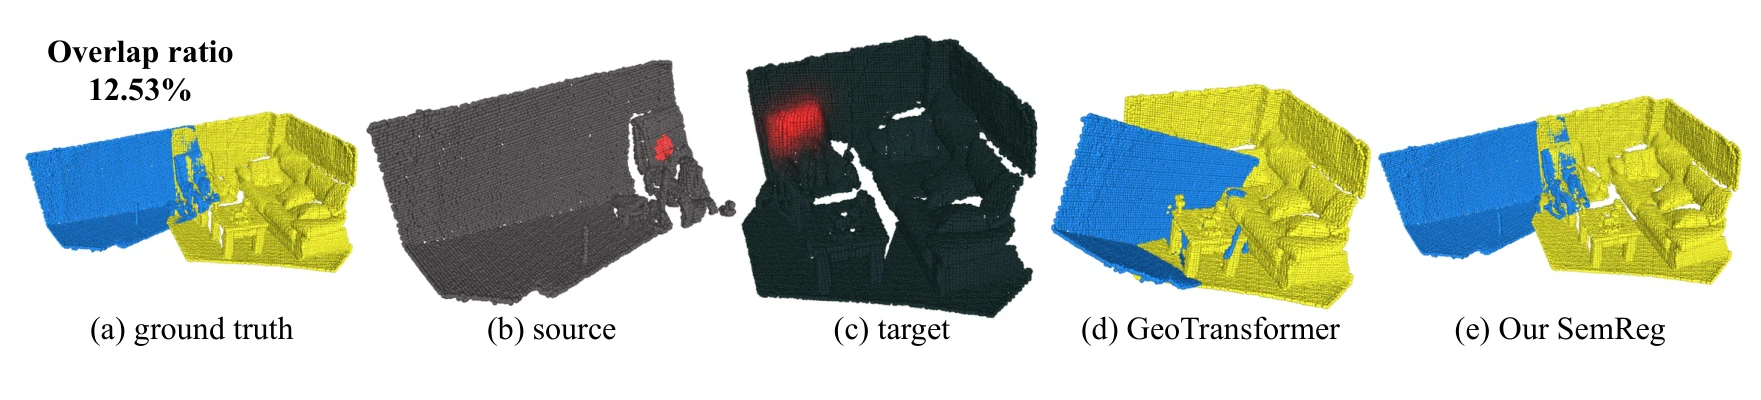
实验使用室内 RGB-D 基准 3DMatch 及其低重叠子集 3DLoMatch(重叠率 10–30% 的扫描对)。配准召回率指估计变换误差(RMSE)小于 0.2 m 的扫描对所占比例。SemReg 在两个子集上均居首位,在 3DMatch 上领先 SIRA-PCR,在 3DLoMatch 上领先 GeoTransformer;在论文的 ICP 精化对比中,它相对次优方法的优势扩大到 1.5 和 2.9 个百分点。重叠越少,语义模块的作用越明显:在 3DLoMatch 上它们贡献了 9.4 个百分点的召回率,而在 3DMatch 上为 2.6 个百分点。在一个重叠率仅 12.53%、唯一共有物体是一把椅子的极端例子中,语义先验依然能在目标点云中找到这把椅子并成功配准,而 GeoTransformer 配准失败。
SemReg 在粗粒度层级上匹配,每对扫描建立 0.1K–1K 个对应关系,而 GeoTransformer 等稠密方法为 6K–7K 个。因此它的内点率(真值变换下距离小于 0.1 m 的对应关系所占比例)低于部分对比方法,但配准召回率更高。室外 KITTI 数据集上的结果见补充材料。该方法依赖与扫描对齐的 RGB 图像,因此不能直接用于单独的点云;作者提出,未来可先由点云渲染出二维图像来解决这一问题。
引用
@inproceedings{fung2024semreg,
  title={Semreg: Semantics constrained point cloud registration},
  author={Fung, Sheldon and Lu, Xuequan and Edirimuni, Dasith de Silva and Pan, Wei and Liu, Xiao and Li, Hongdong},
  booktitle={European Conference on Computer Vision},
  pages={293--310},
  year={2024},
  organization={Springer Nature Switzerland Cham},
  doi={10.1007/978-3-031-72940-9_17}
}