Parallel Grayscale Connected Component Analysis via Neighborhood Labeling and Global Region Mapping
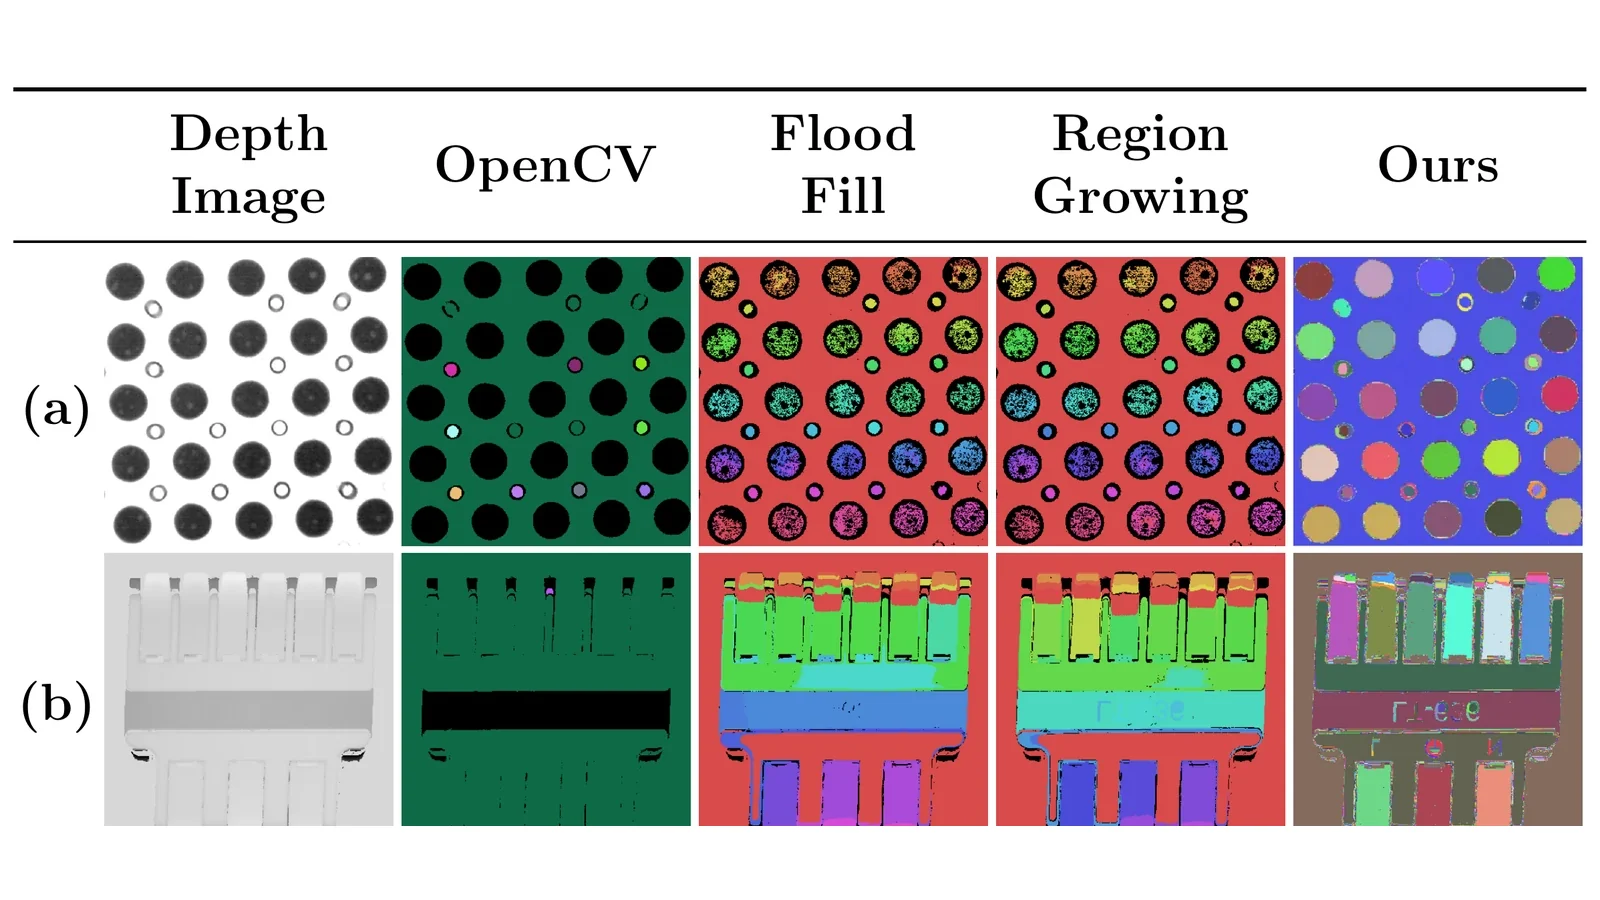
一句话看懂GPU 上的连通域标记通常需要二值图像,会丢掉灰度细节。该方法直接对灰度图和深度图做标记,在紧凑的区域 ID 空间中合并区域,处理一张 200 万像素的深度图约需 1.6 ms。
问题背景
连通域分析(CCA)把灰度值相近的相邻像素归为同一区域,是工业缺陷检测、深度图滤波和医学组织识别中的基础步骤。随着传感器分辨率不断提高,工业产线需要在几毫秒内处理百万像素级图像,同时不能损失分割保真度。
现有方法只能二选一。CPU 上的串行算法,如区域生长和泛洪填充,直接基于灰度运行,能保留精细结构和细微梯度,但速度太慢,无法满足高节拍产线。GPU 上的快速算法,如 OpenCV 的 connectedComponents,面向二值图像设计,需要先做二值化(例如 Otsu 阈值),从而丢弃灰度信息。低对比度缺陷,或灰度相近的相邻深度平面,就会被合并或丢失。
据作者分析,把二值 GPU 算法改造成灰度版本并不简单。二值图像大多是稀疏、分明的团块,而灰度图像存在稠密、连续的梯度。只要相邻像素灰度差不超过阈值就相连,会在像素之间产生多得多的临时等价关系。在标签传播和并行并查集中,这会导致全局内存上严重的原子操作竞争,抵消并行带来的加速。
方法原理
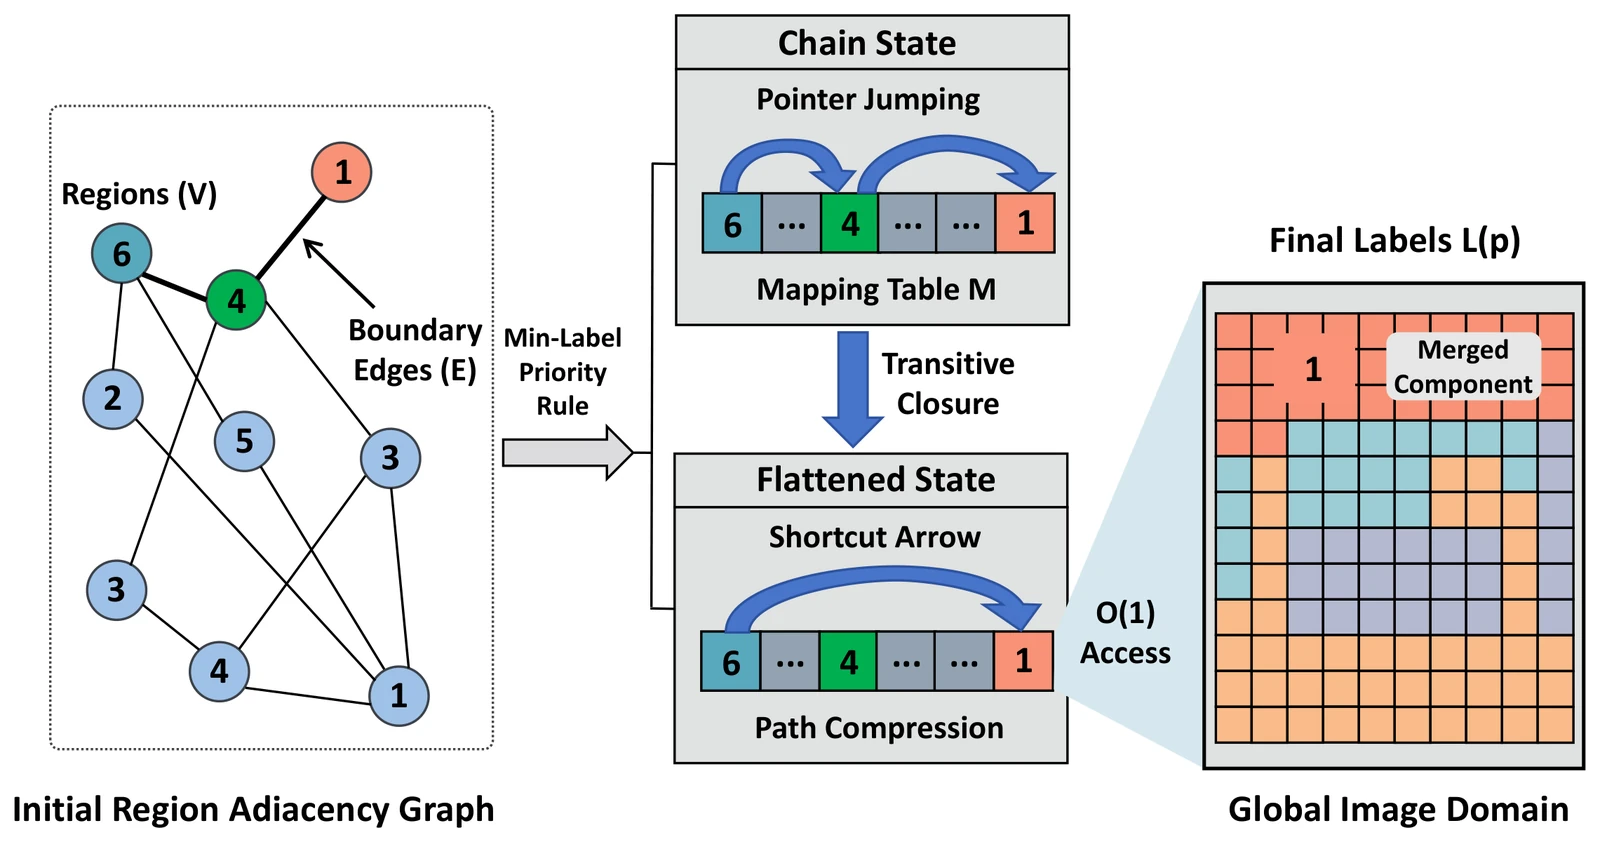
整个方法在 GPU 上运行,直接处理原始灰度值或深度值。两个相邻像素的灰度差不超过阈值 τ,就属于同一区域。该方法不逐像素合并,而是先把图像切成许多小的局部区域,找出这些区域相接的位置,再在规模小得多的区域 ID 空间中合并。
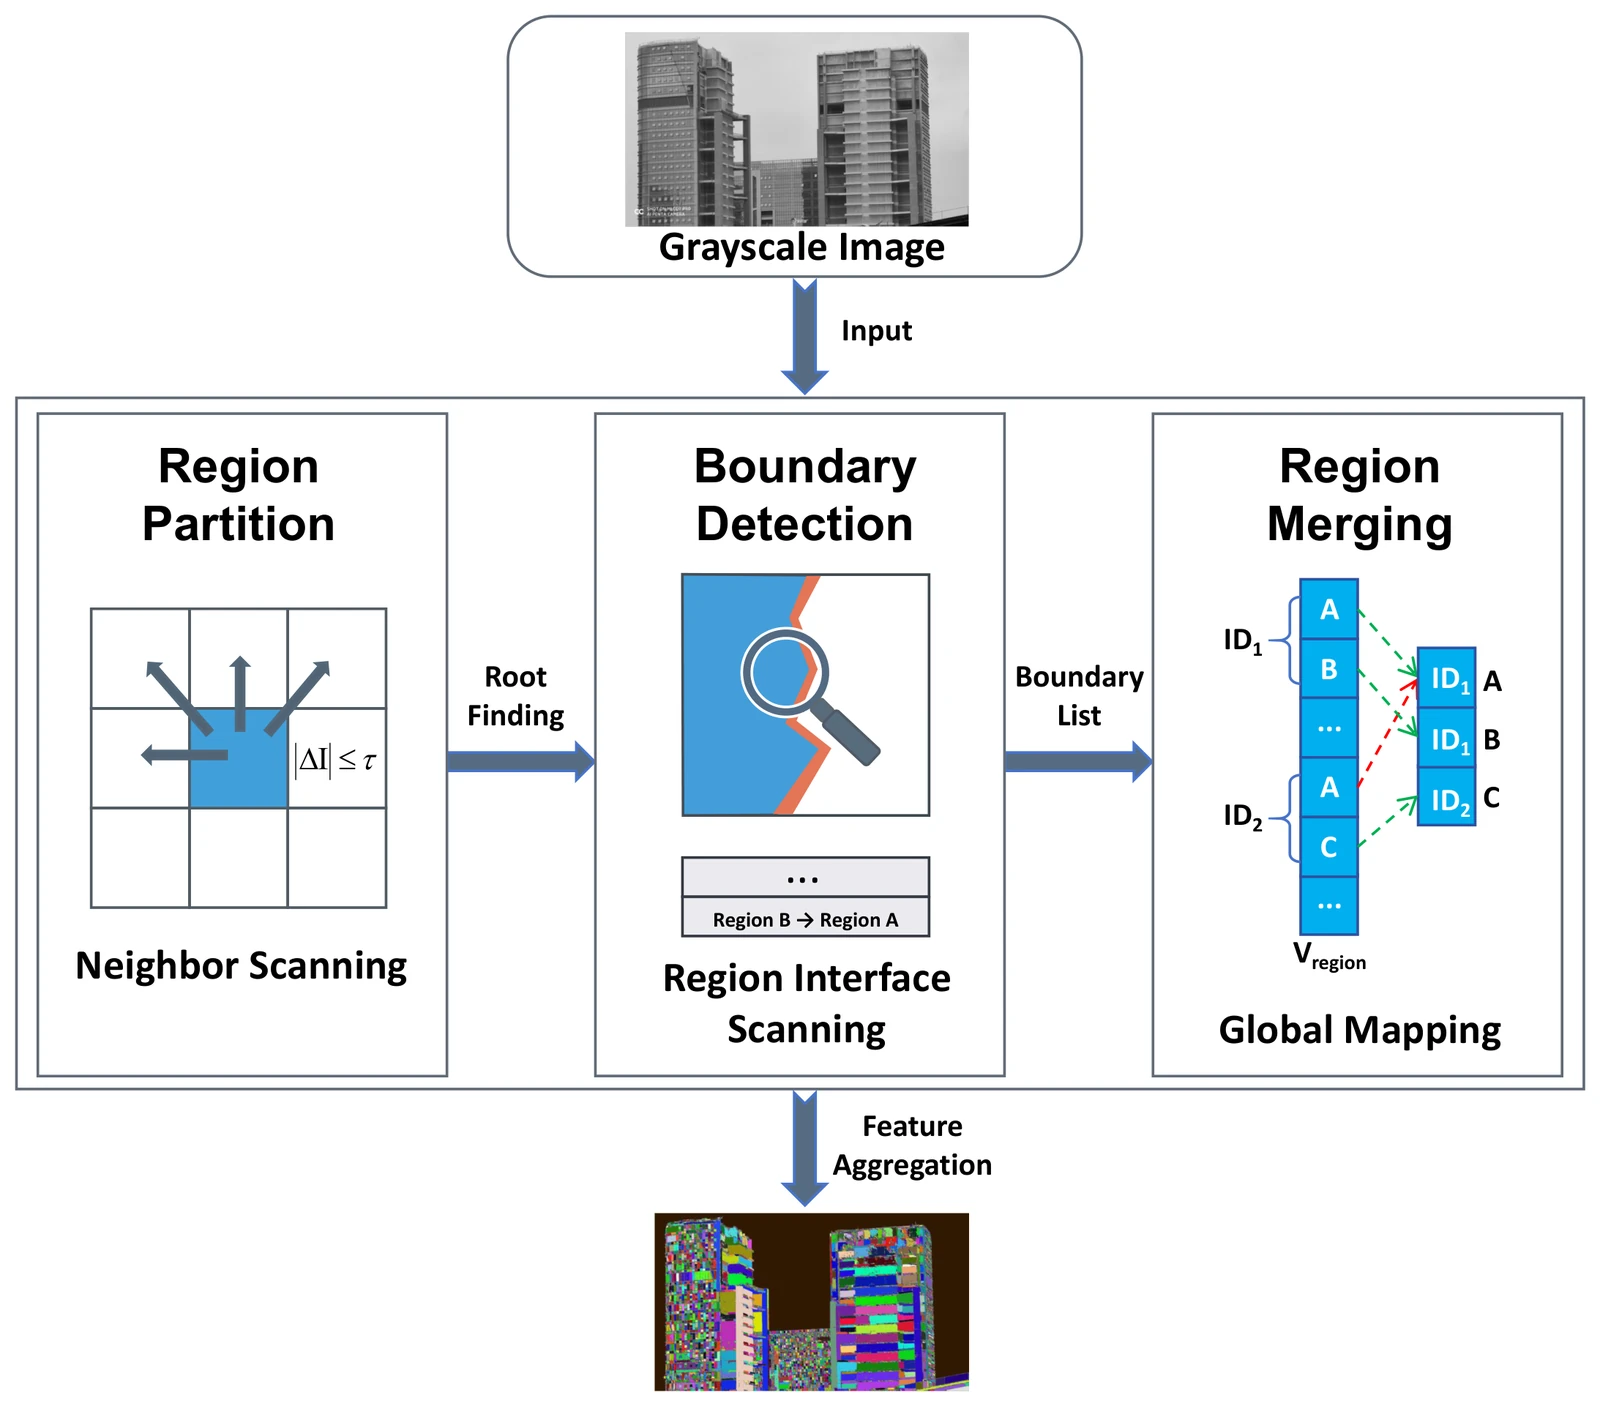
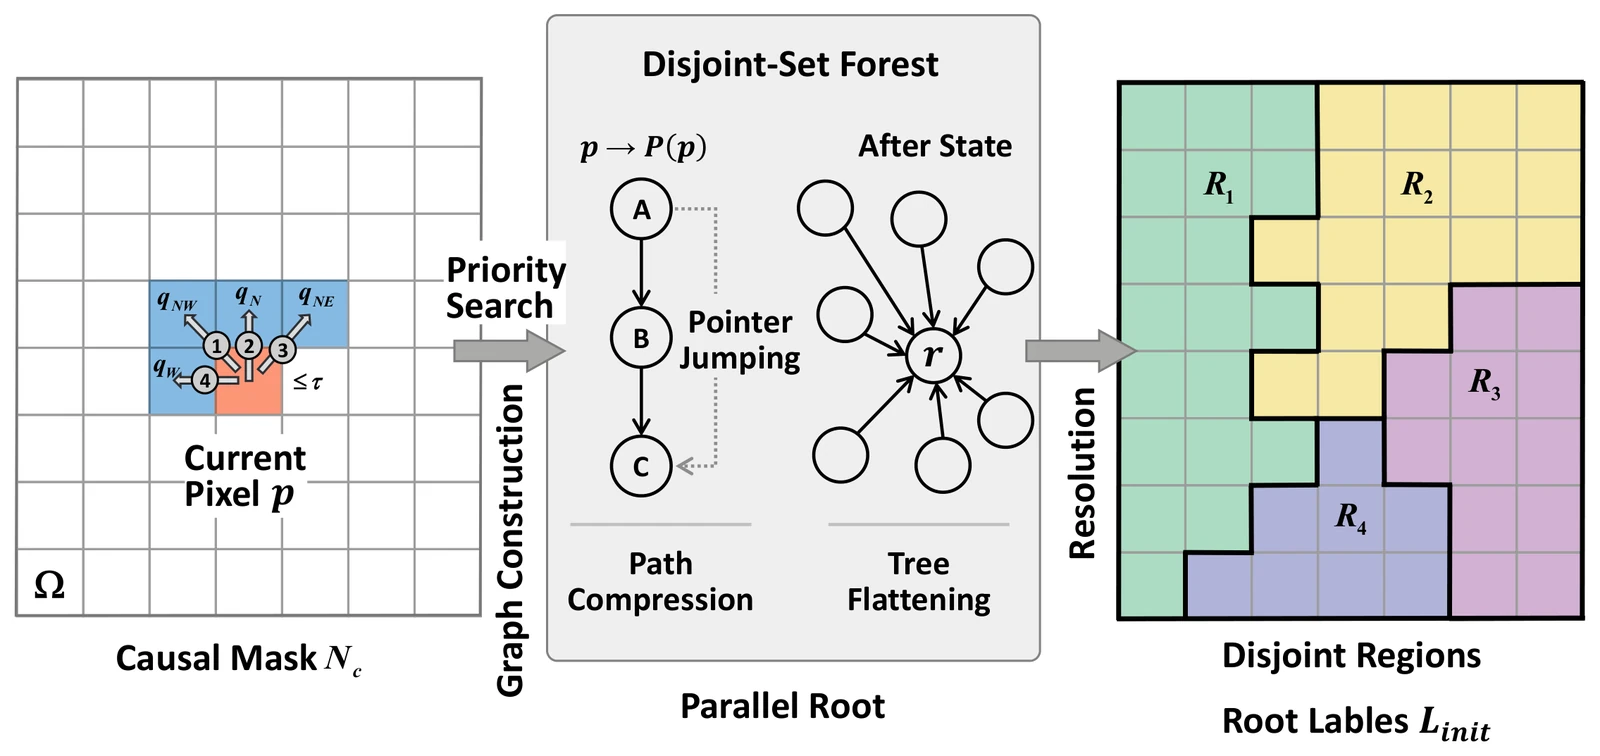
- 局部划分。 每个像素检查按光栅顺序已经扫过的四个邻居:左上、上、右上和左。它按这一固定优先级,连接到第一个灰度差不超过 τ 的邻居;若都不满足,就成为根节点。所有像素并行判断。随后用指针跳跃(路径压缩)让每个像素得到其根节点的 ID。由于掩膜只向后看,某些形状(如 U 形)会被拆成多个初步区域。
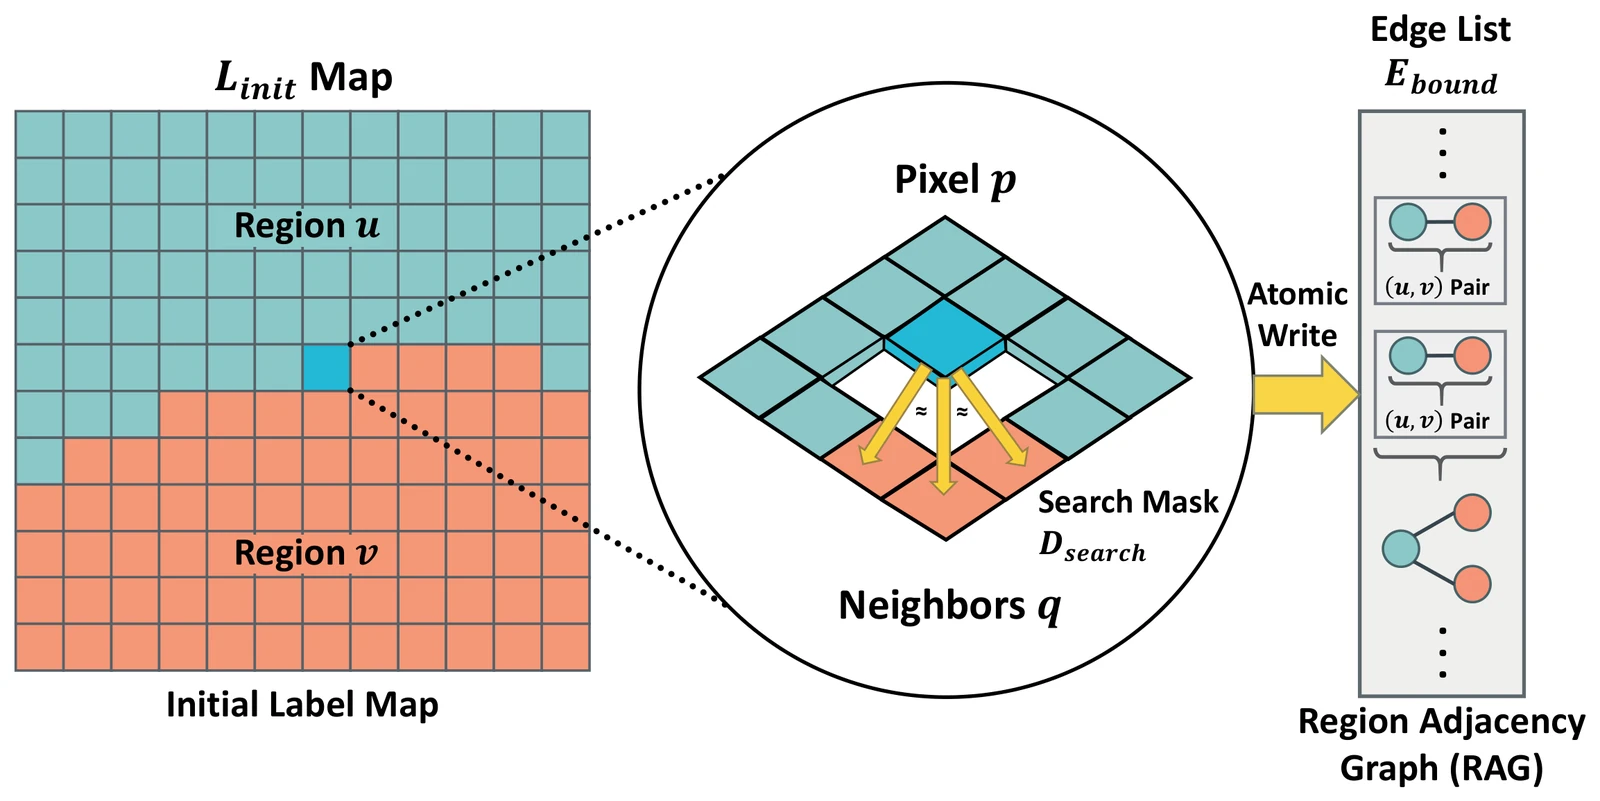
- 边界检测。 为找出这些区域应在何处连接,每个像素检查下方的三个邻居:左下、下和右下。若某个邻居标签不同但灰度差在 τ 以内,就用一次原子索引递增把这对区域 ID 写入边列表。这些边构成区域邻接图,其规模远小于图像本身。
- 全局区域映射。 区域 ID 上的映射表初始为恒等映射。对每条边,把较大的 ID 映射到较小的 ID;沿映射链找到当前的根,因此与多个区域相连的区域最终归入同一个连通域。最后一遍展平使每个表项直接指向其根,再遍历一次图像,把每个像素的标签替换为根。
- 特征聚合。 区域面积等统计量先在每个 GPU 线程块的共享内存中,用一个小哈希表计数,再按块一次性累加到全局内存。这使全局原子操作的次数从每像素一次降到大约每区域每块一次,且整数求和结果精确、确定。面积低于下限的连通域可在同一遍中滤除。
实验结果
算法用 CUDA C++ 实现,在 NVIDIA GeForce RTX 3060 和 Intel Core i5-12500 上测试;耗时为 100 次运行的平均值,不含数据传输。测试图像是 400 × 300 至 4000 × 3000 像素的工业深度图和灰度图。对比方法为 GPU 上的 OpenCV connectedComponents(需要二值图像),以及 CPU 上的串行区域生长和泛洪填充(与本文方法一样基于灰度)。
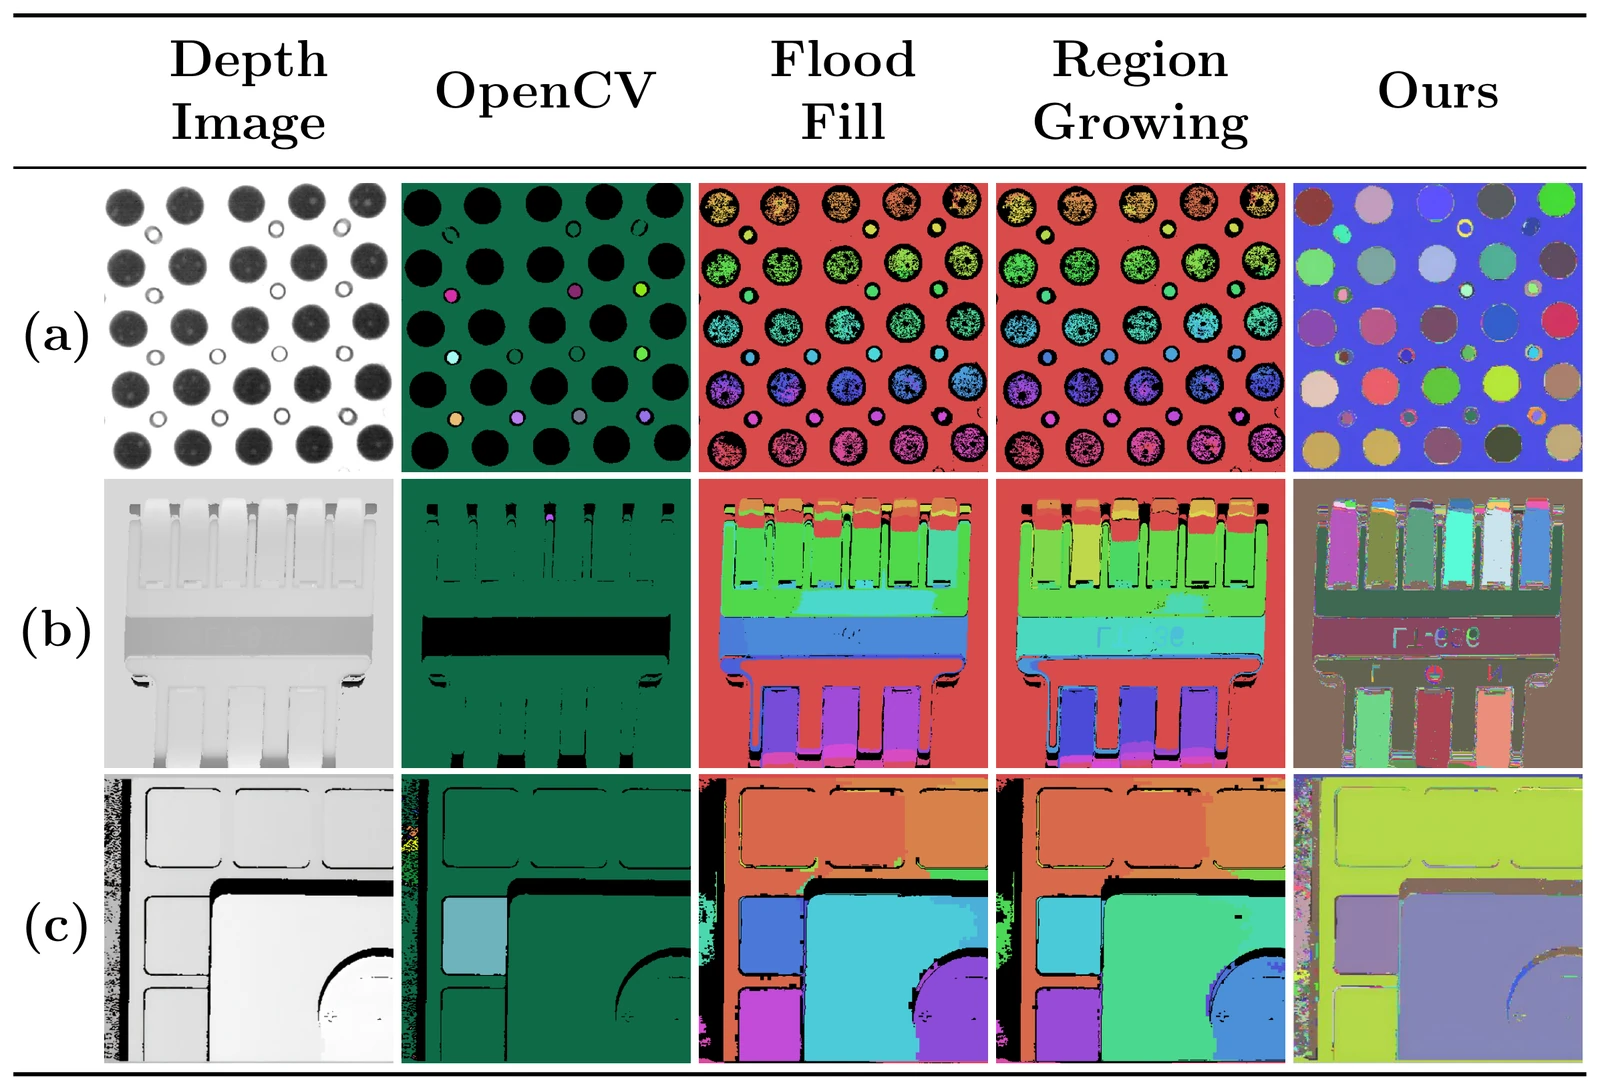
据作者分析,二值化流程在阈值处理后会过度合并或漏掉细微的灰度连通域,而本文方法的区域划分更精细。OpenCV 仍然快得多,因为它标记的是二值图像:在 1920 × 1080 上为 0.194 ms,本文方法为 0.865 ms(表 2)。与灰度基线方法相比,各分辨率下差距都很大:在 4000 × 3000 上,本文方法需要 8.659 ms,区域生长需要 763.75 ms。从 400 × 300 到 4000 × 3000,像素数增加 100 倍,耗时只增加 24.4 倍,从 0.355 ms 增至 8.659 ms。
作为正确性验证,在二值输入、阈值为 1 时,本文方法在三张测试图像上找到的连通域数与 OpenCV 和经典两遍扫描算法完全一致,分别为 475、12,484 和 91,737 个(表 3)。在 IoU 对比中,作者把与区域生长之间的微小差异归因于 CPU 和 GPU 的浮点精度差别。
在 1920 × 1080 图像上的分阶段耗时(表 5)显示:初始标记 0.608 ms,边界检测与映射 0.693 ms,全局区域 ID 合并仅 0.028 ms,最终重标记与统计 0.165 ms。阈值 τ 决定分割的粗细;由于耗时几乎不随连通域数量变化,调节 τ 不会带来延迟代价。由于合并具有传递性,只要相邻像素之间的每一步灰度差都在 τ 以内,平缓的灰度渐变区仍是同一个连通域。作者把自适应阈值、拓扑感知的边界规则和多 GPU 扩展列为后续工作。
引用
@article{cao5854925parallel,
  title={Parallel Grayscale Connected Component Analysis via Neighborhood Labeling and Global Region Mapping},
  author={Cao, Ling and Weng, Jianbo and Lu, Jiawei and Yu, Zihong and Yang, Yong and Feng, Daquan and Pan, Wei},
  journal={Available at SSRN 5854925},
  doi={10.2139/ssrn.5854925}
}